

2進数や論理演算、データ構造、疑似言語の読解を土台に、確率と誤差、整列・再帰の計算量まで学びます。途中の値を自分で追って結果を確かめます。
仕組みを理解する
基礎理論
基礎理論とは、2進数や論理演算など、コンピュータがデータをどう表し、計算するかの土台となる考え方です。
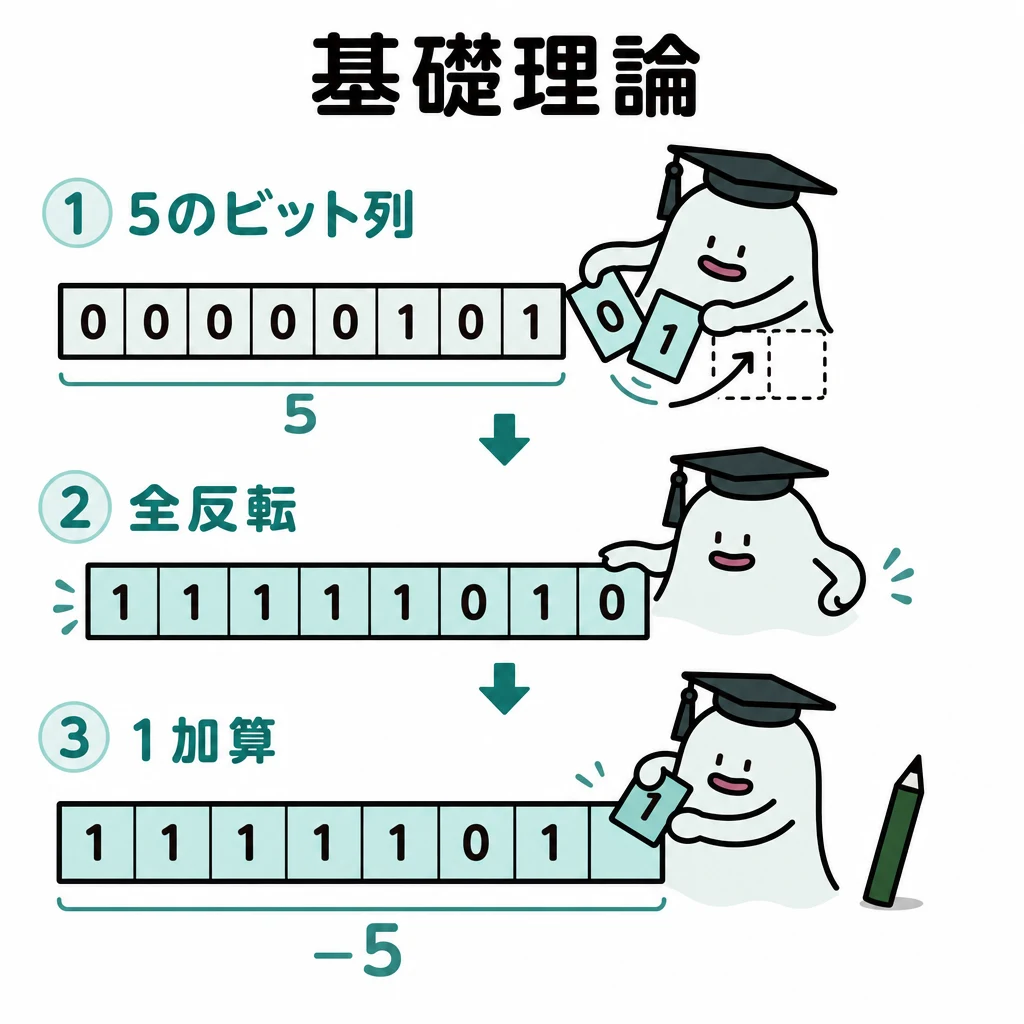
符号付き整数の計算では、同じビット列でも解釈が変わります。まずビット幅と符号の表現方法を固定して考えます。
基本の仕組み
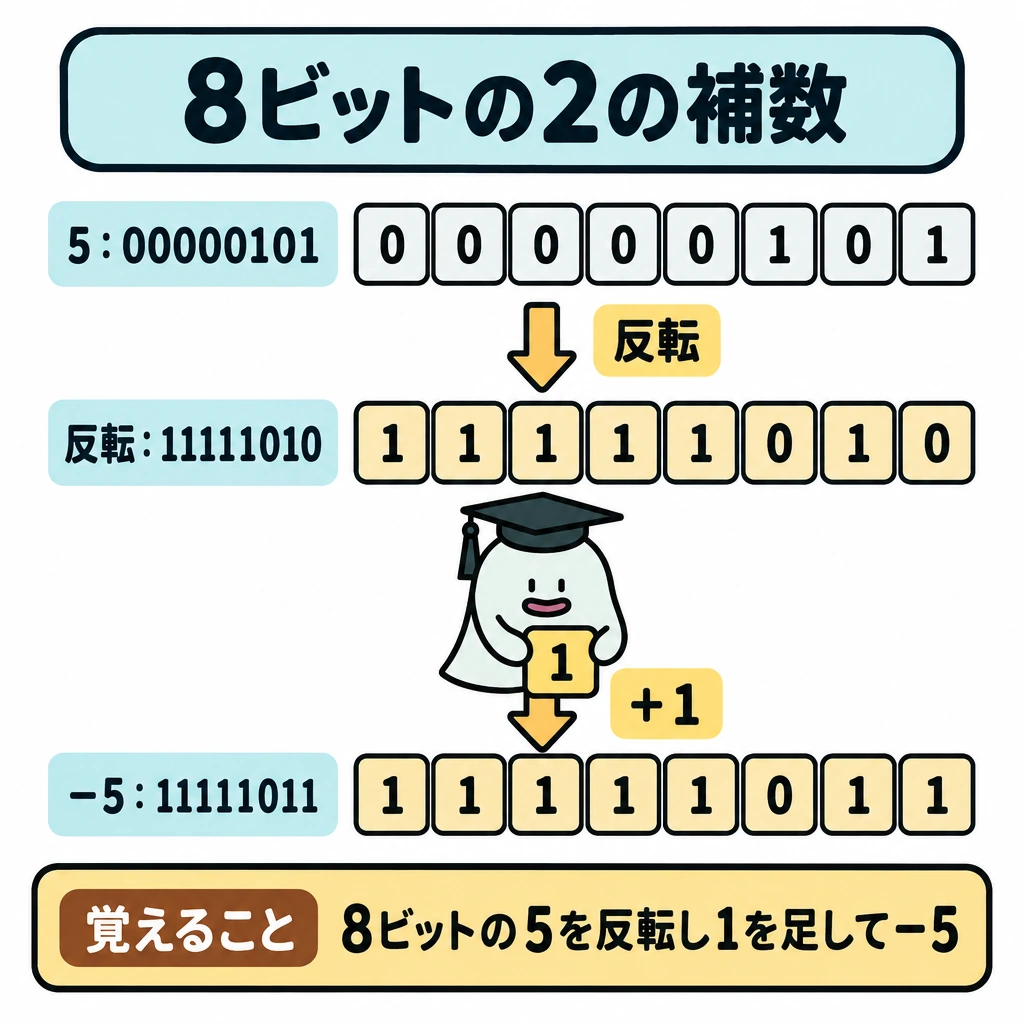
8ビットの2の補数で−5を作るとき、5の00000101を反転し11111010、さらに1を足して11111011にします。
nビットの2の補数は−2のn−1乗から2のn−1乗−1までを表します。8ビットでは−128から127です。論理演算は各ビットの真偽で扱い、数値の加算とは区別します。
最上位が1だからといって、すべての表現で負数になるわけではありません。符号なし整数なら11111011は251です。
NANDはANDの結果を反転します。入力が00・01・10・11の順なら、ANDの出力は0・0・0・1、NANDは1・1・1・0です。XORは二つの入力が異なるとき1になります。論理式は入力の全組合せを表にして、同じ結果になるかを確認できます。
数の表現と論理の全体像
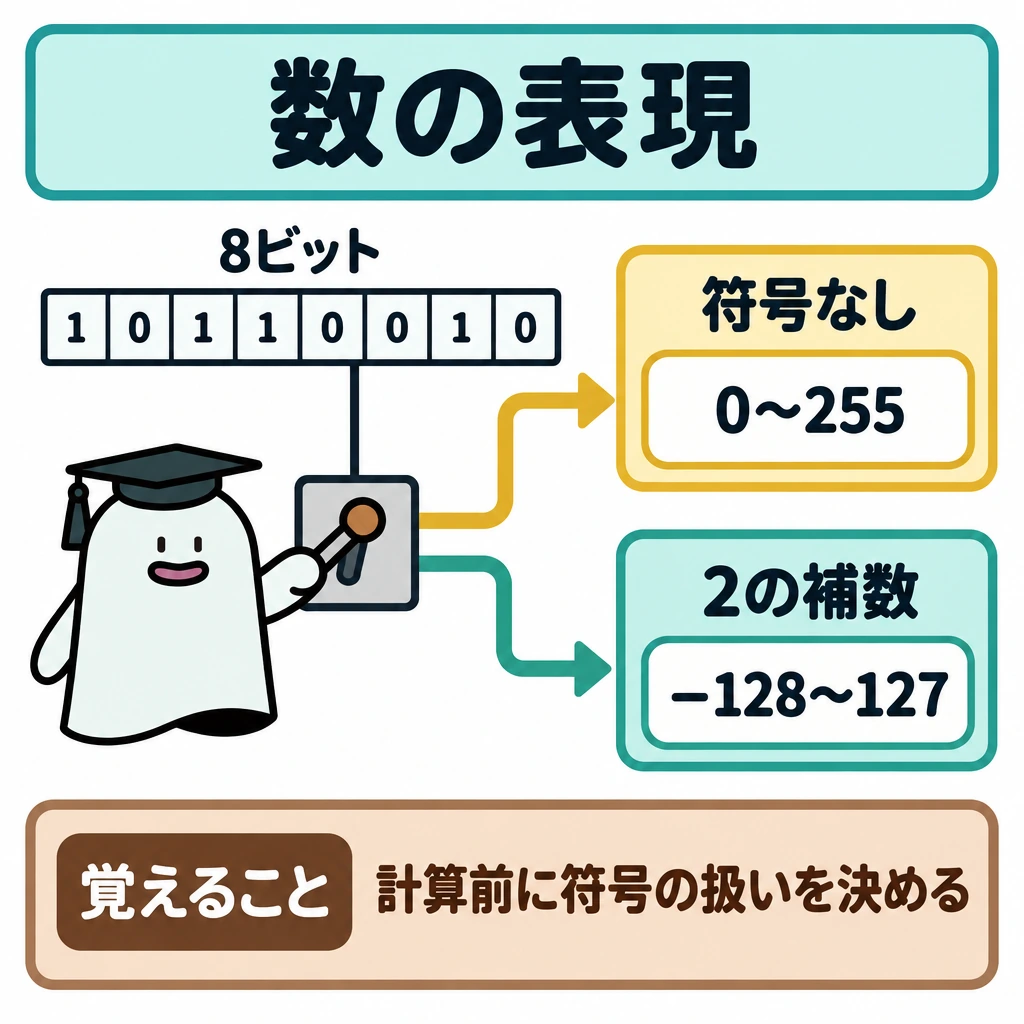
符号なしnビットは0〜2^n−1、2の補数は−2^(n−1)〜2^(n−1)−1を表します。同じビット列でも、符号付きか符号なしかを先に決めてから計算します。
基数変換では各桁の重みを使います。2進数1011.1は8+2+1+0.5=11.5です。16進数へは2進数を4桁ずつ、8進数へは3桁ずつ区切って対応させます(11111011は16進数でFB)。10進数の0.1のように、2進数では有限の桁で表せない小数もあります。
2進数を左へ1ビットシフトすると2倍、右へ1ビットシフトすると1/2(端数は小さい方へ丸め)になります。論理シフトは空いたビットに0を入れ、算術シフトは符号ビットを保ち、右シフトでは空いた上位ビットに符号と同じ値を入れます。
NOTは入力を反転し、NORはORの結果を反転します。AND、OR、XOR、NAND、NORの出力は、次の表のように入力の全組合せで比較します。
| 表現 | 8ビットの範囲 |
|---|---|
| 符号なし | 0〜255 |
| 2の補数 | −128〜127 |
| 入力A・B | AND | OR | XOR | NAND | NOR |
|---|---|---|---|---|---|
| 0・0 | 0 | 0 | 0 | 1 | 1 |
| 0・1 | 0 | 1 | 1 | 1 | 0 |
| 1・0 | 0 | 1 | 1 | 1 | 0 |
| 1・1 | 1 | 1 | 0 | 0 | 0 |
試験に出る
- 2進数と10進数の相互変換。各桁の重みを足して求める計算。
- 2進数と16進数は4桁ずつ対応させる変換と、1ビットの左シフトで2倍・右シフトで1/2になる関係。
- 8ビットの2の補数が表す範囲(−128〜127)と、5の反転+1で−5を作る手順。
- NAND・XORの真理値。NANDはANDの反転、XORは入力が異なるとき1。
- 符号付きと符号なしで同じビット列の意味が変わる点(11111011は−5か251か)。
- 桁あふれを捨てて計算する例(5+(−5)=0)。
重要な言葉
- 2の補数
- 負の整数を表す表現方法。ビットを反転して1を足す。
- 論理演算
- 0と1の真偽を組み合わせて結果を求める演算。ANDやORなど。
- NAND
- ANDの結果を反転した論理演算。
- 桁あふれ
- 計算結果が表せるビット幅を超えること。
確認問題
確かめよう8ビットの2の補数で00000101と11111011を足すと?
桁あふれを捨てて00000000です。
8ビットの2の補数で5と−5を足すと、桁あふれを捨てて0になる。
XORは、二つの入力が同じときに1になる。
8ビットの2の補数で−5を表すビット列は?
NANDの出力が0になるのはどの入力のとき?
の計算では、同じビット列でも解釈が変わります。まずと符号の表現方法を固定して考えます。
8ビットので−5を作るとき、5の00000101を反転し11111010、さらに1を足してにします。
nビットの2の補数は−2のn−1乗から2のn−1乗−1までを表します。8ビットではから127です。は各ビットの真偽で扱い、数値の加算とは区別します。
が1だからといって、すべての表現で負数になるわけではありません。符号なし整数なら11111011はです。
はANDの結果を反転します。入力が00・01・10・11の順なら、ANDの出力は0・0・0・1、NANDは1・1・1・0です。は二つの入力が異なるとき1になります。論理式は入力の全組合せを表にして、同じ結果になるかを確認できます。
データ構造
データ構造とは、データの並べ方と取り出し方の違いを表す型で、用途に合う構造を選ぶことで処理しやすくなります。
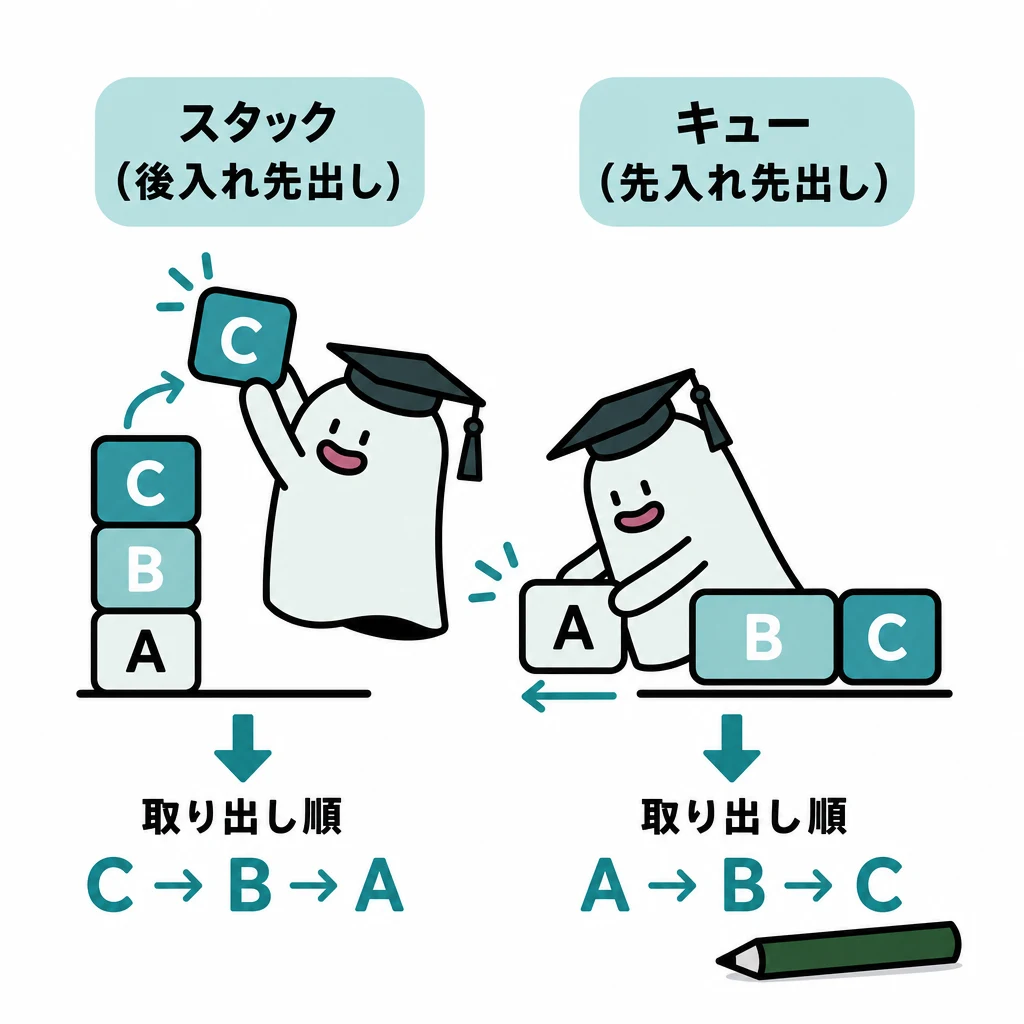
データをどの順番で取り出すかによって、適した構造が変わります。皿の積み重ねと受付の列を比べてみましょう。
基本の仕組み
A、B、Cの順に入れると、スタックはC、B、Aの順、キューはA、B、Cの順で取り出します。前者は後入れ先出し、後者は先入れ先出しです。
配列は添字で直接要素を参照しやすく、連結リストは次の要素への参照をたどります。木は親子関係を持ち、根から枝を選んで要素を探せます。
連結リストの途中への挿入が容易でも、挿入位置を探すコストが消えるわけではありません。操作の前提と全体の処理量を分けて考えます。
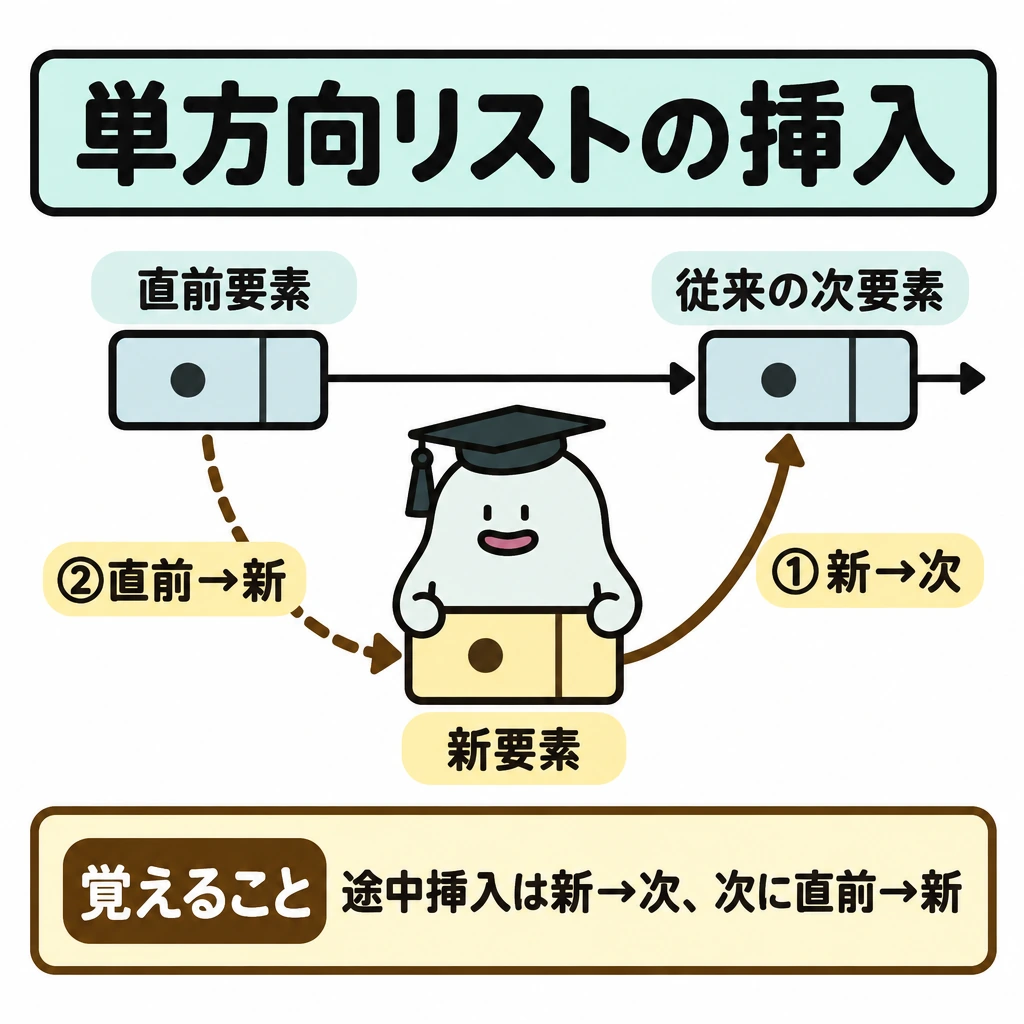
単方向リストは、各要素が次の要素への参照を持つ連結リストです。途中へ要素を挿入するには、新要素を従来の次要素へつなぎ、直前要素の参照を新要素へ変更します。先に参照を上書きして後続への道を失わないよう、更新順を追います。
構造を選ぶ条件
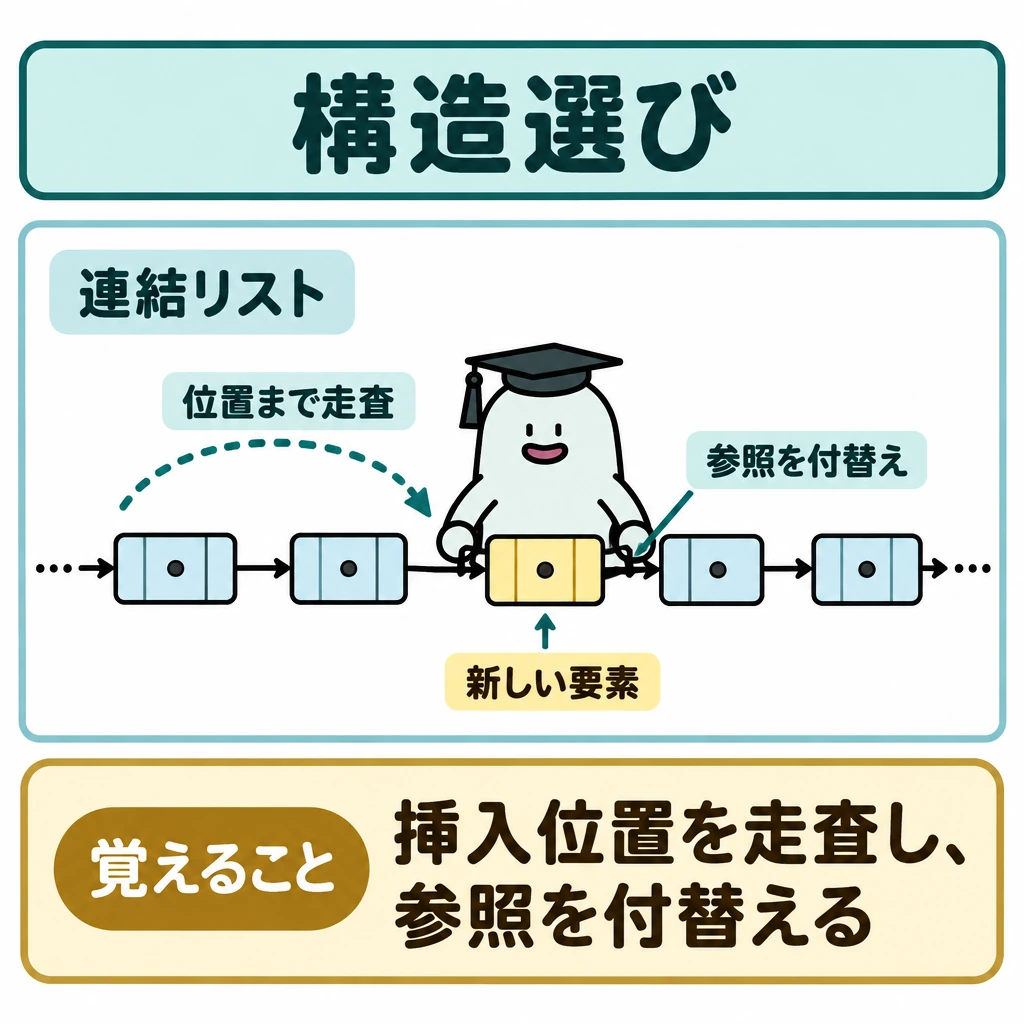
配列は添字による直接参照に向きます。連結リストは参照の付替えで挿入できますが、挿入位置を探す走査は必要です。スタックは後入れ先出し、キューは先入れ先出しで要素を取り出します。
木は親子関係を表す構造です。2分探索木は「左の子孫<節<右の子孫」となるよう値を置き、根から大小比較で左右へ進んで探します。ヒープは親が子以上(または以下)となる完全2分木で、最大値(最小値)を根から取り出せます。ハッシュ表はキーから計算した位置へ格納します。
| 構造 | 代表的な操作・性質 |
|---|---|
| スタック | push・pop(後入れ先出し) |
| キュー | enqueue・dequeue(先入れ先出し) |
| 連結リスト | 参照をたどる・付け替える |
| 2分探索木 | 左<節<右の大小で探索 |
| ヒープ | 親が子以上(以下)で根が最大(最小) |
| ハッシュ表 | キーから格納位置を計算 |
試験に出る
- スタック(後入れ先出し)とキュー(先入れ先出し)の取り出し順。
- 配列は添字で直接参照、連結リストは次の要素をたどるという違い。
- 単方向リストの挿入で参照を付け替える順序と、走査の手順。
- 挿入が容易でも挿入位置を探すコストは残ること。
- Undoなど用途からスタックかキューかを選ぶ判断。
重要な言葉
- スタック
- 最後に入れたものを最初に取り出す後入れ先出しの構造。
- キュー
- 最初に入れたものを最初に取り出す先入れ先出しの構造。
- 連結リスト
- 各要素が次の要素への参照を持ち、順にたどる構造。
- 単方向リスト
- 次の要素への参照だけを持つ連結リスト。
確認問題
確かめようUndoで直前の操作から戻すならどちら?
スタック。最後に行った操作を先に取り出します。
スタックは、先に入れた要素を先に取り出す。
単方向リストは、次の要素への参照だけを持つ。
最後に入れた要素を最初に取り出す構造は?
各要素が次の要素への参照だけを持つ構造は?
データをどの順番で取り出すかによって、適した構造が変わります。とを比べてみましょう。
A、B、Cの順に入れると、はC、B、Aの順、はA、B、Cの順で取り出します。前者は後入れ先出し、後者は先入れ先出しです。
は添字で直接要素を参照しやすく、は次の要素への参照をたどります。木は親子関係を持ち、根から枝を選んで要素を探せます。
の途中への挿入が容易でも、挿入位置を探すコストが消えるわけではありません。操作の前提と全体のを分けて考えます。
は、各要素が次の要素へのを持つ連結リストです。途中へ要素を挿入するには、新要素を従来の次要素へつなぎ、直前要素の参照を新要素へ変更します。先に参照を上書きして後続への道を失わないよう、更新順を追います。
アルゴリズム
アルゴリズムとは、問題を解くための手順であり、整列の有無など前提によって適した方法が変わります。
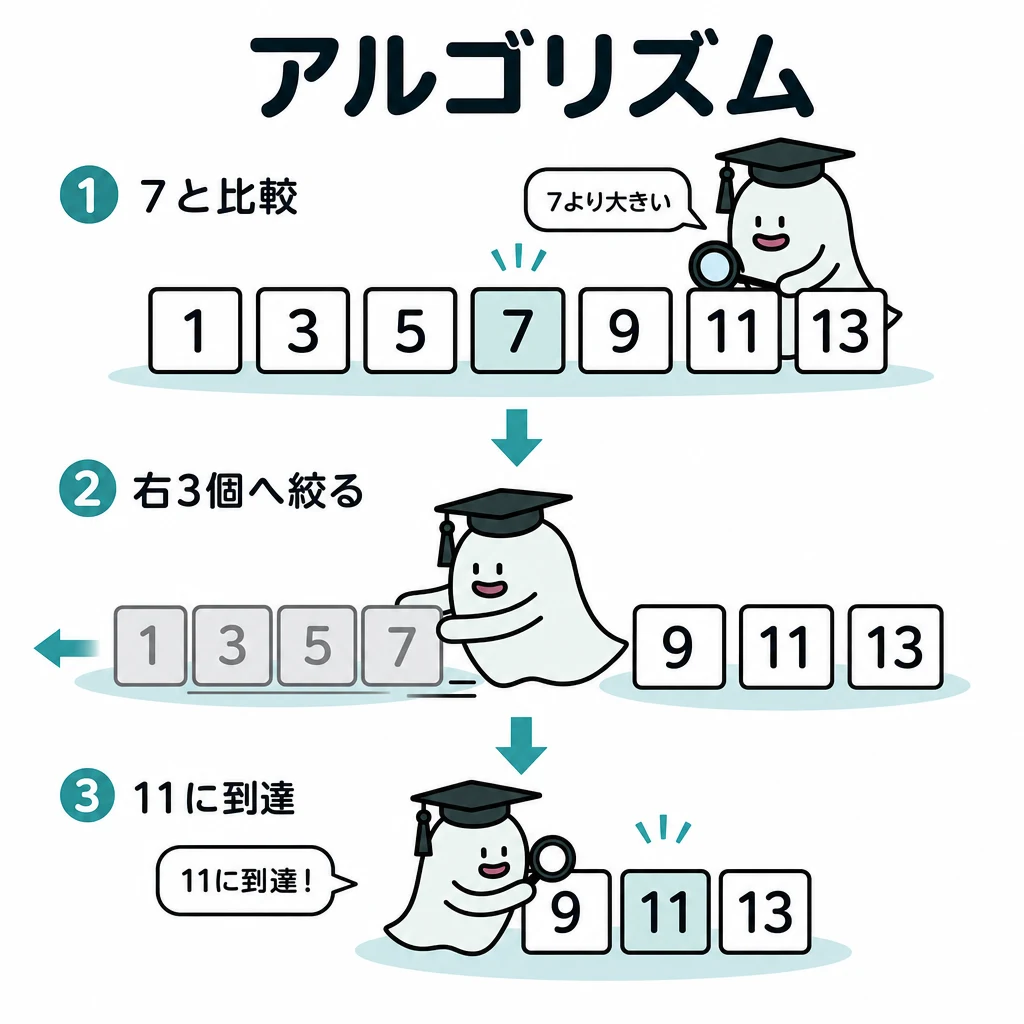
大量の番号から目的の番号を探すとき、毎回すべてを読む必要があるでしょうか。整列済みなら、中央との比較で候補を半分にできます。
基本の仕組み
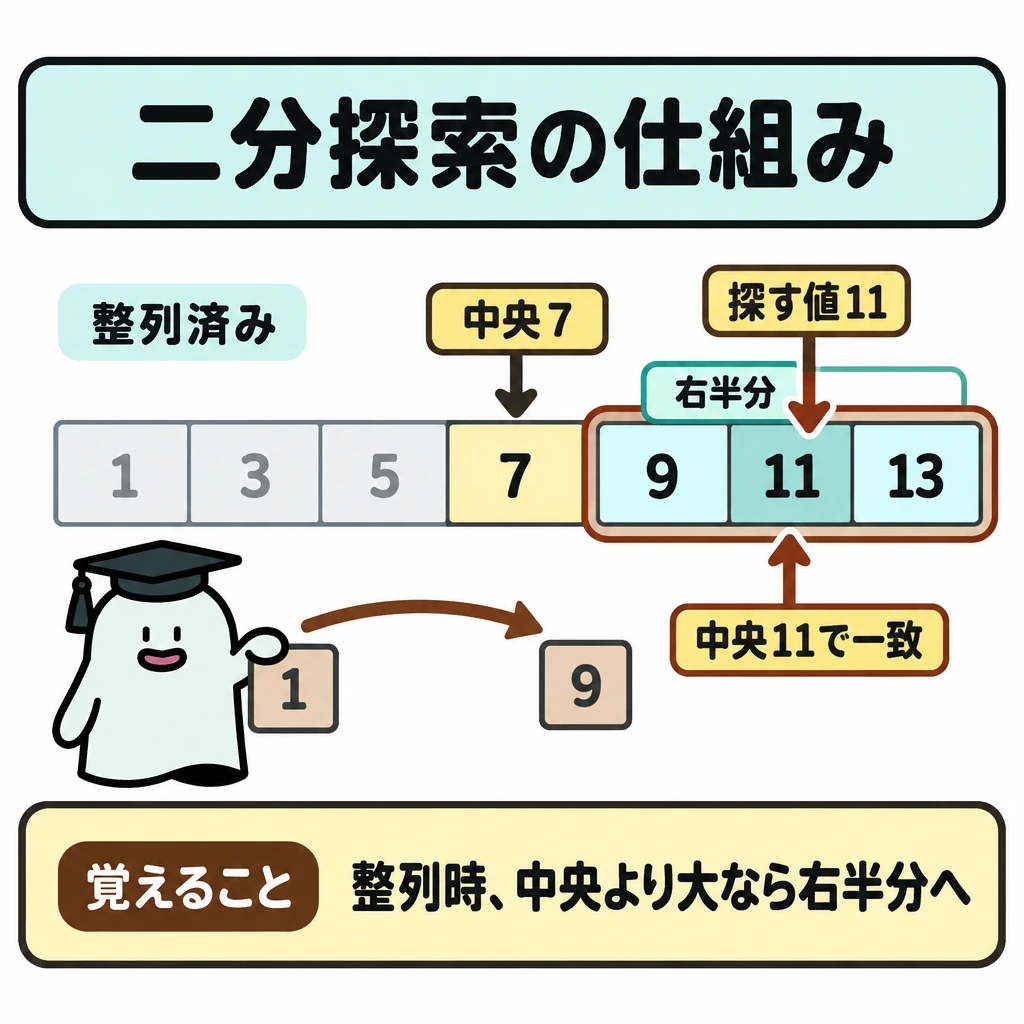
1、3、5、7、9、11、13から11を探すと、中央7より大きいので右半分へ進み、9、11、13の中央11で一致します。
二分探索は整列を前提とし、比較のたびに下限または上限を更新します。候補を約半分にするため、探索の比較回数は要素数nに対しておおむねlog₂nの規模です。最大比較回数は⌊log₂n⌋+1回(⌊ ⌋は小数点以下切捨て)で、16個なら5回です。
未整列の配列では、中央より大きい値が左にもあるため半分を捨てられません。添字の更新を誤ると同じ範囲を繰り返して終了しない場合があります。
探索方法の前提
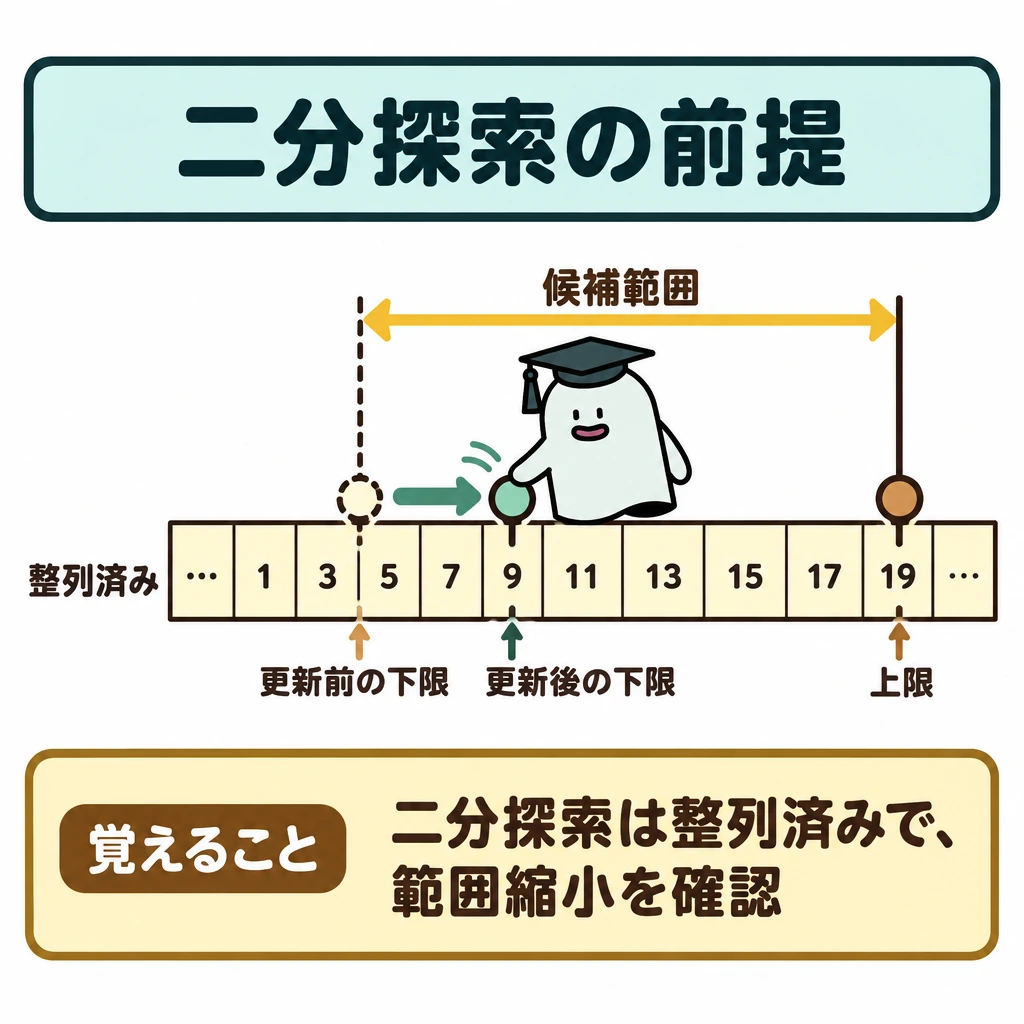
線形探索は未整列でも使えます。n個から探すと比較回数は最悪n回、見つかる場合の平均は(n+1)/2回で、計算量はO(n)です。二分探索は整列済みを前提にO(log n)です。二分探索では、下限・上限の更新後も候補範囲が必ず縮むかを確かめます。
ハッシュ探索は、キーから計算した位置(ハッシュ値)を直接調べます。異なるキーが同じ位置になる衝突が少なければ平均O(1)ですが、衝突が多いと比較回数が増えます。
| 探索 | 必要な前提 | 比較回数の目安 |
|---|---|---|
| 線形 | 整列不要 | 平均(n+1)/2回、最悪n回 |
| 二分 | 整列済み | 最大⌊log₂n⌋+1回 |
| ハッシュ | キーの変換と衝突処理 | 衝突がなければ1回 |
試験に出る
- 二分探索は整列済みが前提という条件。
- 比較のたびに下限・上限を更新し、候補が約半分になること。
- 探索の比較回数が要素数nに対しておおむねlog₂n、最大は⌊log₂n⌋+1回であること。線形探索の平均(n+1)/2回との比較。
- 未整列では中央で半分を捨てられないこと。
- 添字更新を誤ると終了しない場合があること。
重要な言葉
- 二分探索
- 整列済みのデータで中央と比較し、候補を半分に絞る探索。
- 計算量
- 処理に必要な手間を要素数との関係で表した量。
- 線形探索
- 先頭から順に比較して目的の値を探す方法。
確認問題
確かめよう候補が16個なら、半分に4回絞ると何個?
1個。16→8→4→2→1です。
二分探索は、データが未整列でも使える。
候補が16個のとき、半分に絞る操作を4回行うと1個になる。
二分探索が前提とする条件は?
候補16個を半分に絞る操作を繰り返すと、1個になるまで何回?
大量の番号から目的の番号を探すとき、毎回すべてを読む必要があるでしょうか。なら、中央との比較で候補をにできます。
1、3、5、7、9、11、13から11を探すと、より大きいのでへ進み、9、11、13の中央11で一致します。
は整列を前提とし、比較のたびに下限または上限を更新します。候補を約半分にするため、探索の比較回数は要素数nに対しておおむねの規模です。最大比較回数は⌊log₂n⌋+1回(⌊ ⌋は小数点以下切捨て)で、16個なら5回です。
の配列では、中央より大きい値が左にもあるため半分を捨てられません。の更新を誤ると同じ範囲を繰り返して終了しない場合があります。
疑似言語と科目B読解
疑似言語とは、プログラムの処理を日本語に近い形で表した記述で、変数の値を一行ずつ追って読解します。IPAの試験では「擬似言語」と表記します。
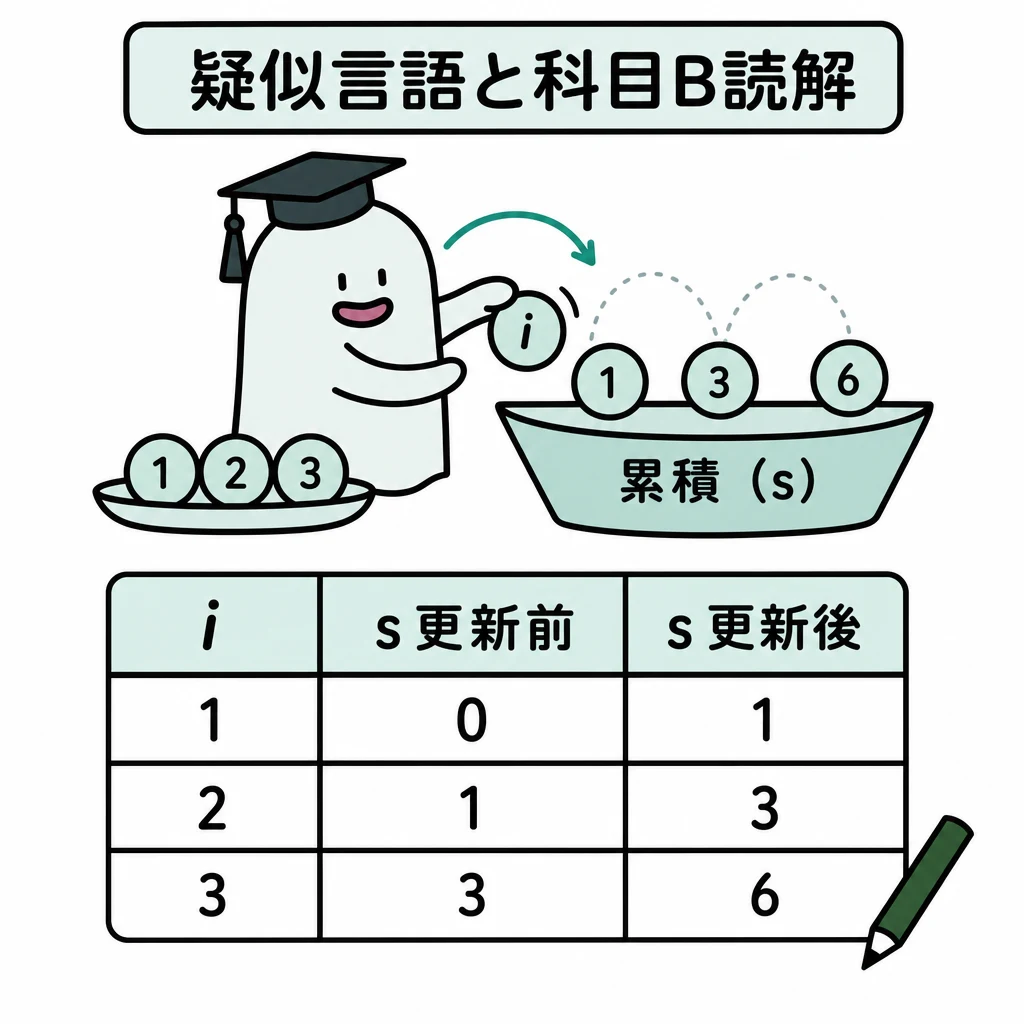
コードを眺めて答えを予想するより、変数の値を一行ずつ追うと確実です。疑似言語では問題ごとの添字や範囲の約束も読みます。
基本の仕組み
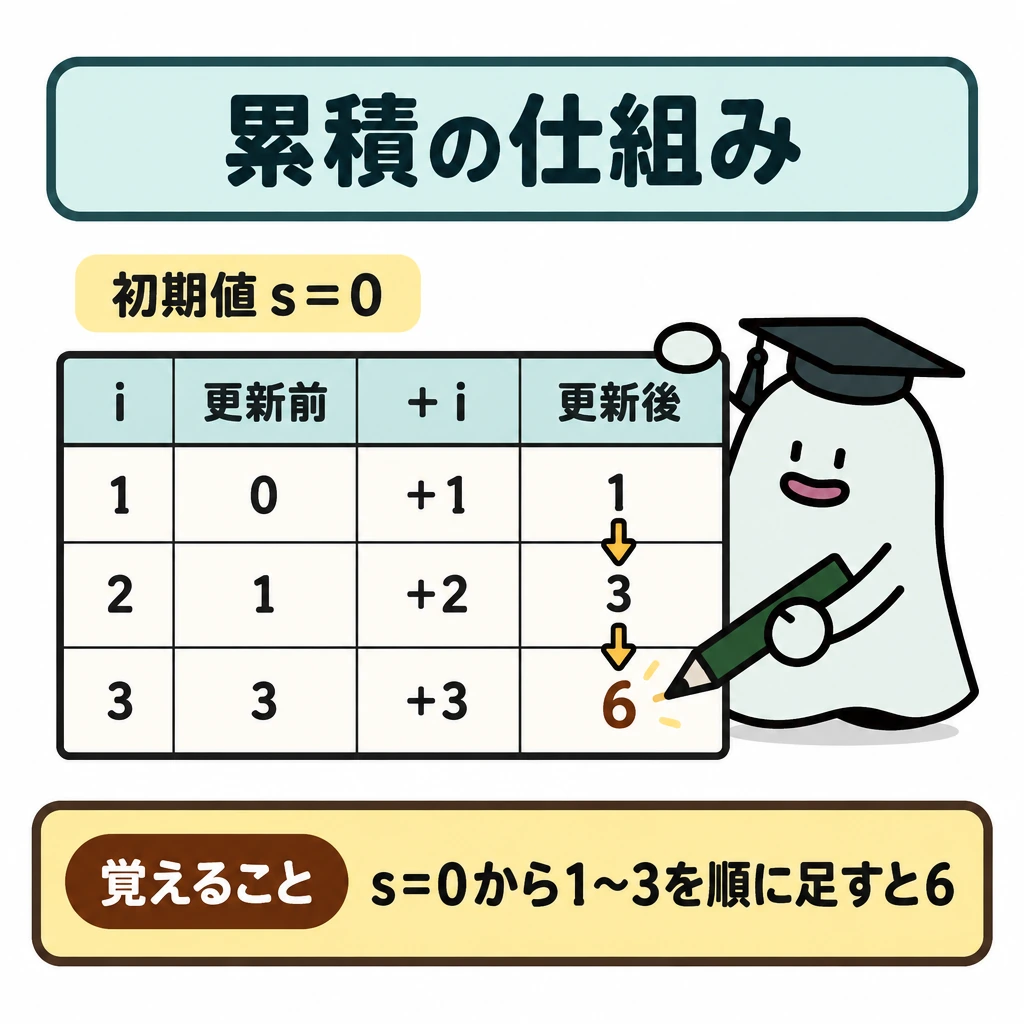
s ← 0として、iを1から3まで1ずつ増やしながらs ← s+iを実行すると、sは1、3、6と変わります。更新前と更新後を分けた表を作ると、何が累積されたか分かります。
条件分岐は条件を評価した時点の値で進む先が決まり、反復では終了条件を再評価します。配列の走査では、添字(要素番号)がどこからどこまで動くかを先に確認します。
科目Bの問題文では「配列の要素番号は1から始まる」と注記されるのが通例です。一般的なプログラミング言語の0始まりと混同すると、参照する要素が一つずれます。また、ループの外で初期化する変数と毎回初期化する変数では結果が変わります。
科目Bの追跡手順
IPAの擬似言語の記述形式では、代入を「変数名 ← 式」、剰余算をmodで書きます。選択はif〜elseif〜else〜endifで、条件式を上から評価し、最初に真になった処理だけを実行します。値が格納されていない状態は「未定義」と呼びます。
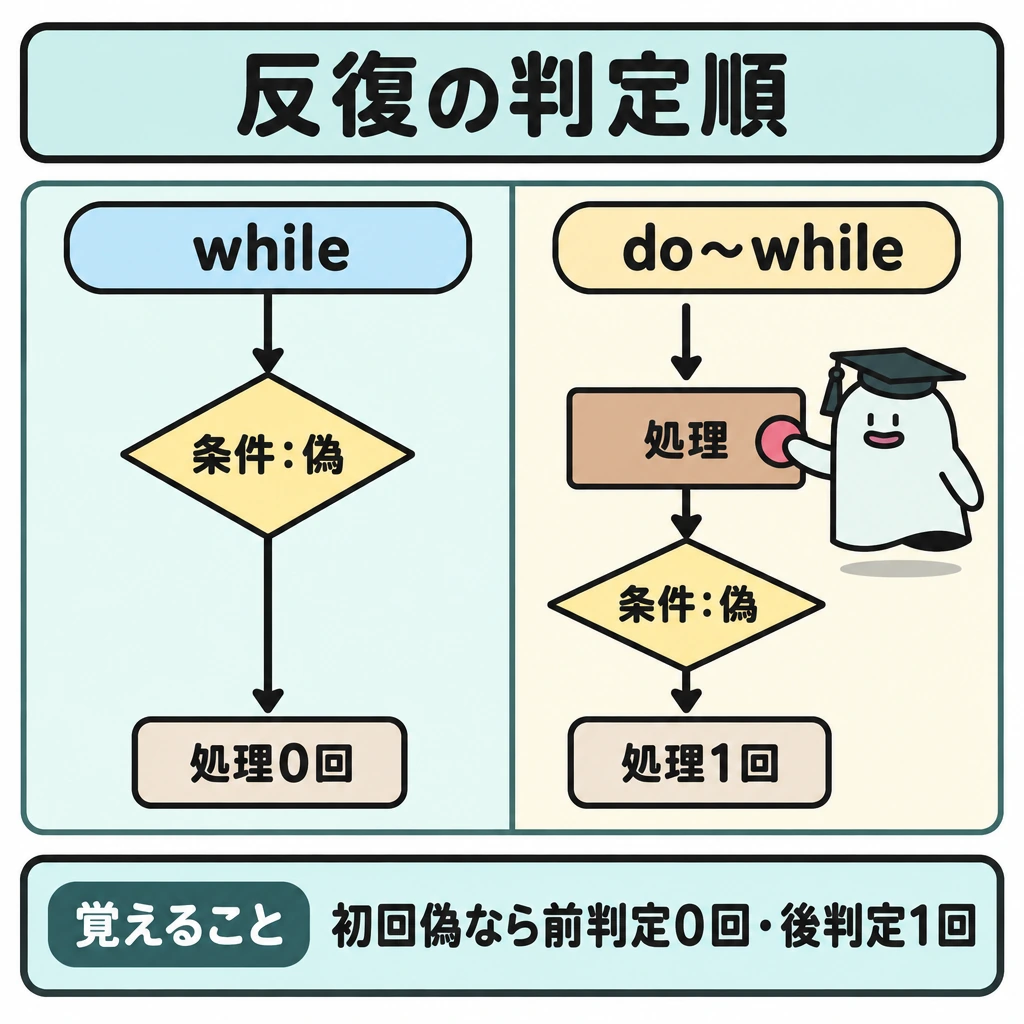
繰返しのwhileは前判定で、条件が最初から偽なら一度も実行しません。do〜whileは後判定で、処理を必ず1回は実行します。forは制御記述(例:iを1からnまで1ずつ増やす)に従って繰り返します。
演算子の優先順位は、単項のnot・+・−が最も高く、乗除(mod・×・÷)、加減、関係演算子(≠・≦・=など)、and、orの順に低くなります。「a or b and c」は「a or (b and c)」と読みます。
読解では、変数の型、要素番号の開始、引数と戻り値を問題文で確認します。分岐の真偽と反復の各回で変わる値を表にし、境界値と終了条件を追います。最大値を判定する条件なら、候補が他の全ての値以上であることを確かめる必要があります。
| 確認点 | 誤読しやすい点 |
|---|---|
| 要素番号 | 1始まりか(問題文の注記)と末尾 |
| 選択 | elseifは最初に真になった処理だけ実行 |
| 反復 | 前判定か後判定か、更新と終了判定の順序 |
| 演算子 | andはorより先に評価 |
| 引数・戻り値 | 呼出し元の値が変わるか、何を返すか |
試験に出る
- 変数の値を一行ずつ追って表にするトレース。
- ループの初期化を外に置くか毎回行うかで結果が変わる点。
- 科目Bの配列は問題文の注記どおり要素番号1から始まる点(0始まりと混同しない)。
- 代入の←、剰余のmod、andがorより先に評価される優先順位など、擬似言語の記述形式。
- 条件分岐は評価時点の値、反復は終了条件を再評価する点。whileは前判定、do〜whileは後判定。
- 累積の有無で最終値が変わる計算例。
重要な言葉
- 疑似言語
- 処理の流れを日本語に近い形で表した記述。
- トレース
- 変数の値を一行ずつ追って処理結果を確かめること。
- ループ
- 条件が成り立つ間、同じ処理を繰り返す構造。
確認問題
確かめよう各反復の初めにs ← 0で戻したら最終値は?
3。合計が蓄積されなくなるためです。
ループの中で毎回変数を初期化すると、値が累積されない。
0始まりの配列と1始まりの配列を混同しても結果は同じ。
処理の値を一行ずつ追って確かめることを何という?
合計用の変数をループの中で毎回0に戻すと、合計はどうなる?
コードを眺めて答えを予想するより、を一行ずつ追うと確実です。では問題ごとの添字や範囲の約束も読みます。
s ← 0として、iを1から3まで1ずつ増やしながらを実行すると、sは1、3、6と変わります。更新前と更新後を分けた表を作ると、何がされたか分かります。
は条件を評価した時点の値で進む先が決まり、反復ではを再評価します。配列の走査では、添字(要素番号)がどこからどこまで動くかを先に確認します。
科目Bの問題文では「配列の要素番号は1から始まる」と注記されるのが通例です。一般的なプログラミング言語のと混同すると、参照する要素が一つずれます。また、の外で初期化する変数と毎回初期化する変数では結果が変わります。
確率・統計と数値誤差
確率・統計とは、でたらめな事象やデータの傾向を数値で捉える方法で、計算には有限桁による誤差も伴います。
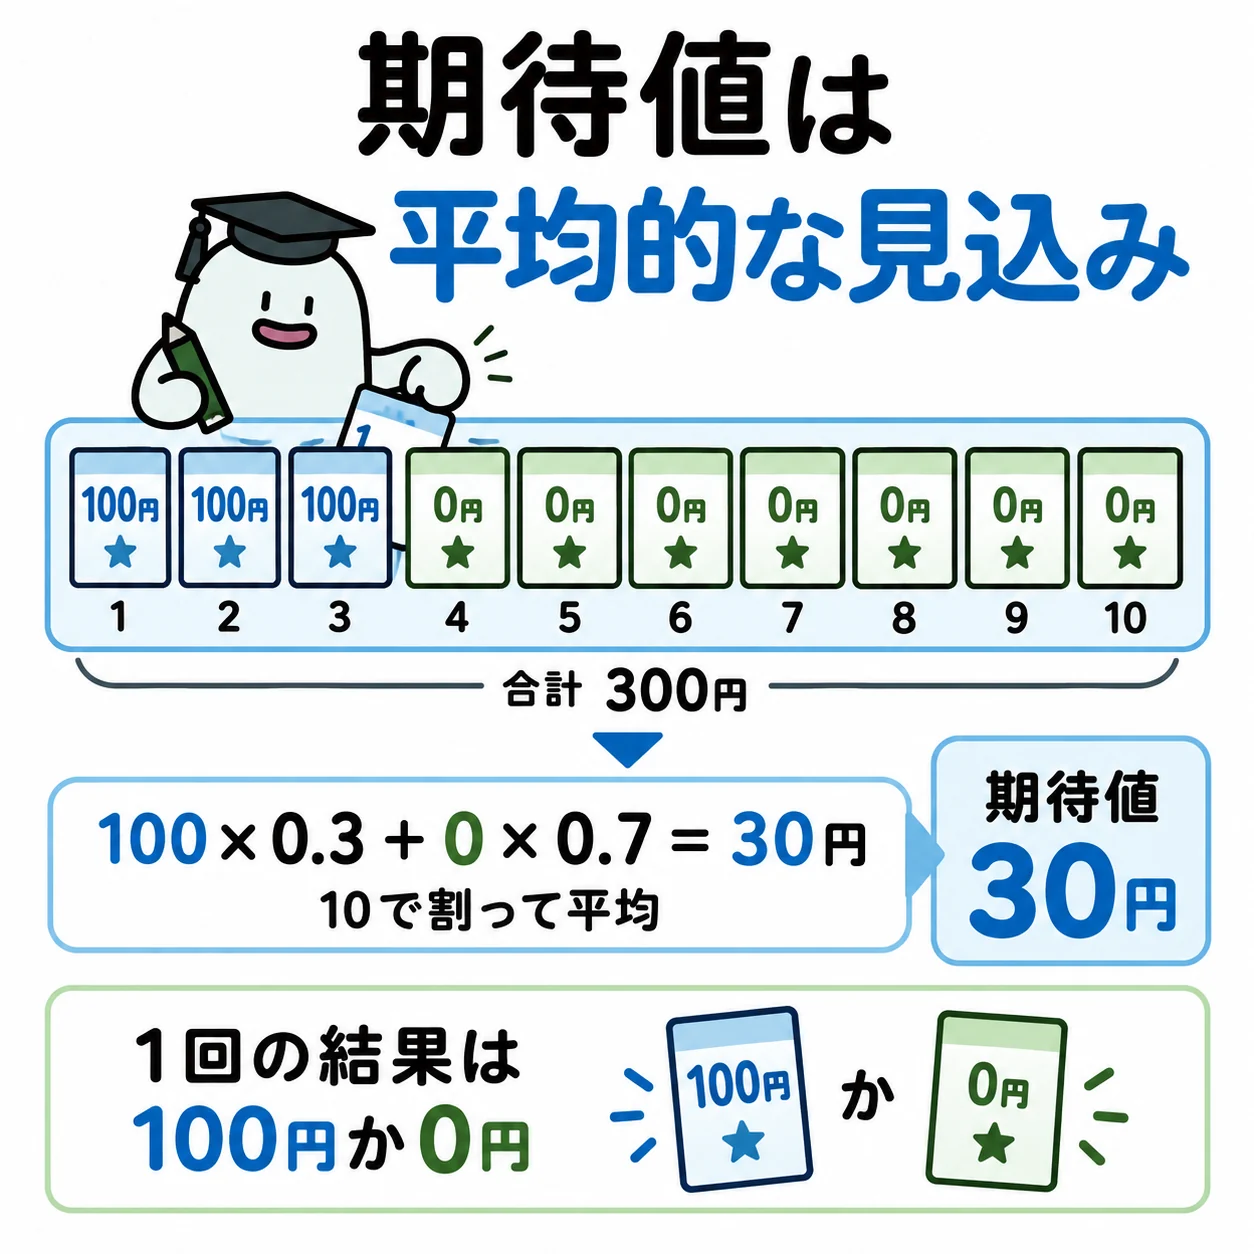
データから判断するときは、平均だけでなく散らばりや偶然の影響を考えます。コンピュータの計算にも、有限の桁数で表すことによる誤差があります。
基本の仕組み
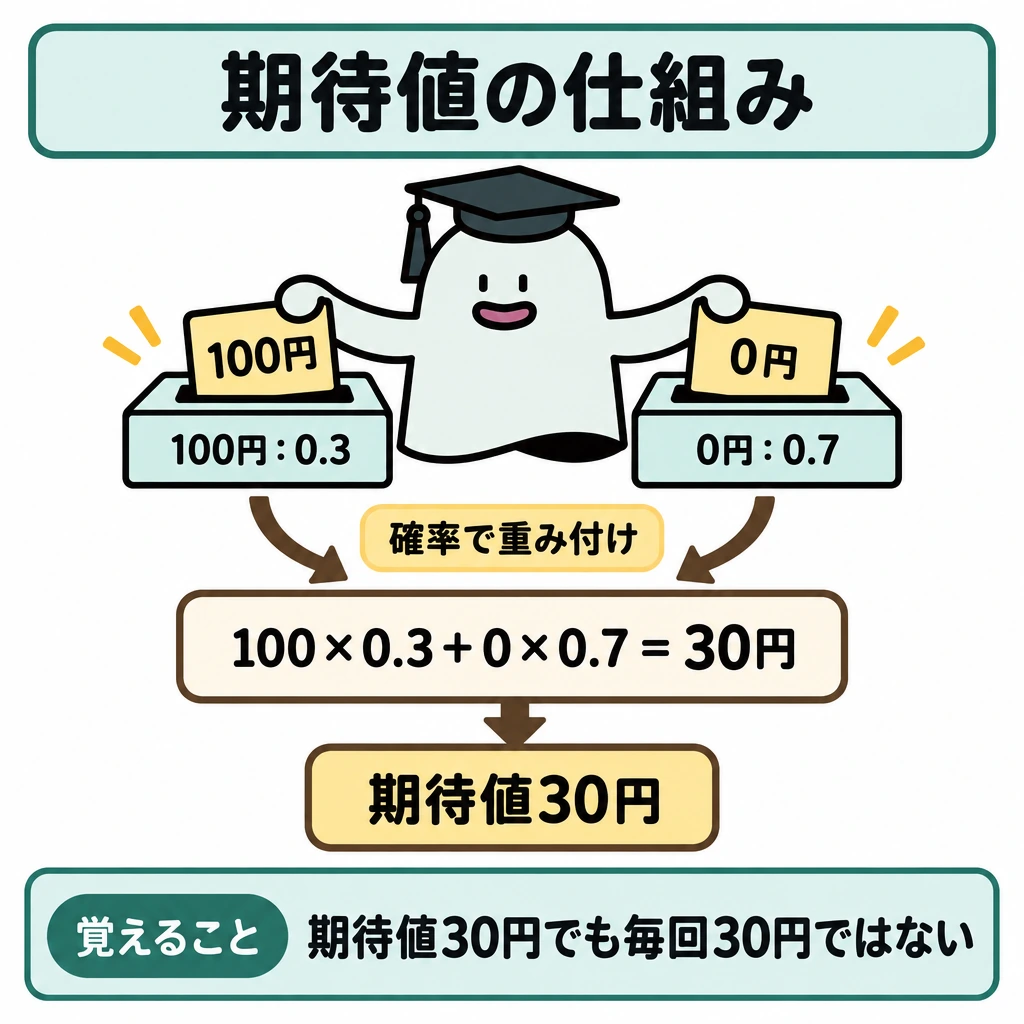
100円を受け取る確率が0.3、0円が0.7なら期待値は100×0.3+0×0.7=30円です。これは一回必ず30円になるという意味ではなく、結果を確率で重み付けした値です。
分散は平均からのずれを二乗して平均した量で、標準偏差はその平方根です。例えば2、4、6の平均は4、分散は{(−2)²+0²+2²}÷3=8/3、標準偏差は約1.63です。
標本から母集団を推測するときは、抽出の偏りと標本数を確認します。独立な二事象が両方起こる確率は積になりますが、独立でない場合にそのまま掛けてはいけません。
丸め誤差は表現できる桁に切り詰めることで生じ、桁落ちは近い値の差を取って有効な桁が減る現象です。発生確率pの情報量は−log₂pビットで、珍しい事象ほど大きくなります。これらを単なるプログラムの誤記と混同しないようにします。
確率・誤差の判別
独立な事象がともに起こる確率は積、排反な(同時には起こらない)事象のいずれかが起こる確率は和です。
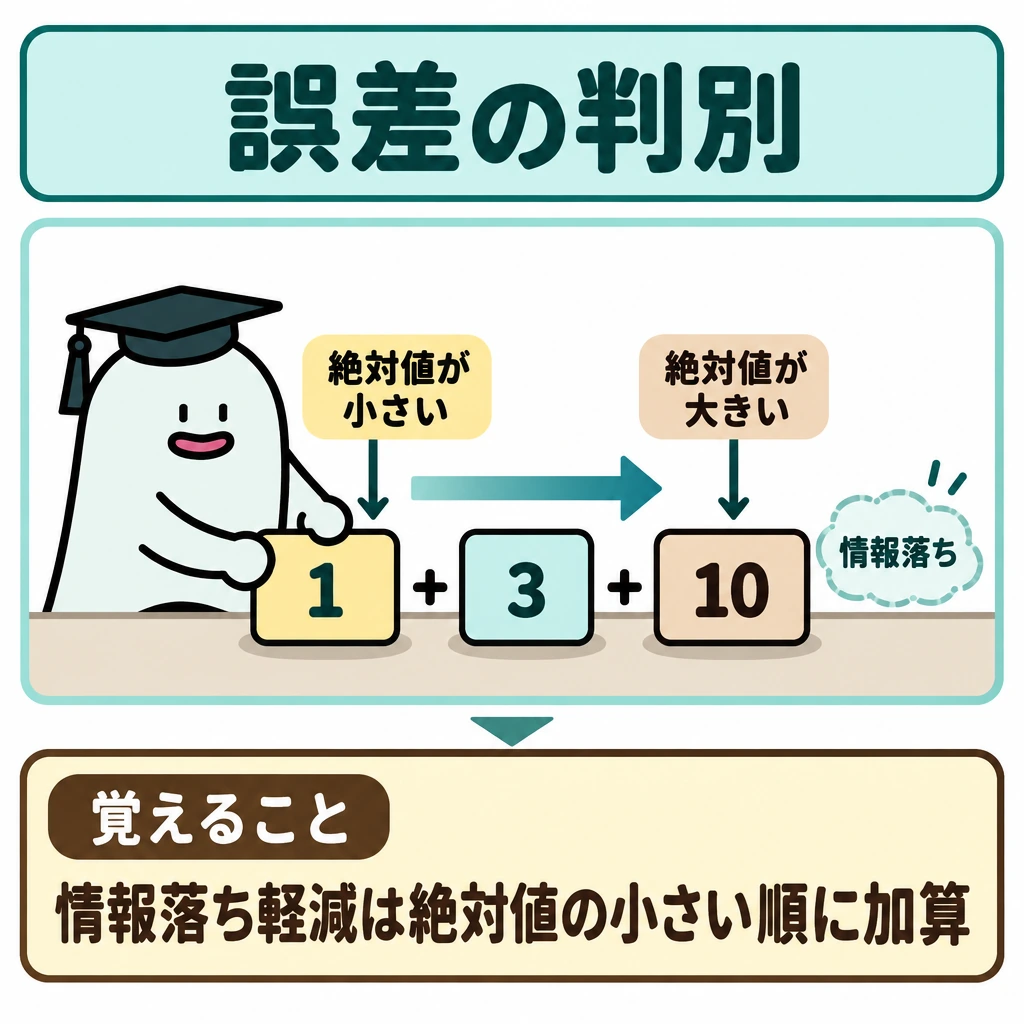
浮動小数点数の丸め誤差、打切り誤差、桁落ち、情報落ち、オーバーフローは発生の仕方が異なります。情報落ちを減らすには、絶対値の小さい数から順に加えます。有効桁数を超えた結果を無条件に正確とみなしません。
| 誤差 | 生じる場面 |
|---|---|
| 丸め誤差 | 表現できる桁へ丸める |
| 打切り誤差 | 無限に続く計算を途中で打ち切る |
| 桁落ち | 値がほぼ等しい数どうしの減算 |
| 情報落ち | 絶対値の大きい数へ小さい数を加減する |
| オーバーフロー | 表現できる範囲を超える |
試験に出る
- 期待値は結果を確率で重み付けした値で、1回の結果と一致しないこと。
- 分散は平均からのずれの二乗平均、標準偏差はその平方根。
- 丸め誤差と桁落ちの違いと発生原因。
- 情報量は−log₂pビットで、珍しい事象ほど大きいこと。
- 独立でない事象の同時確率を単純に掛けてはいけない点。
重要な言葉
- 期待値
- 結果を確率で重み付けして足し合わせた平均的な値。
- 標準偏差
- 分散の平方根で、データの散らばりの大きさを表す。
- 丸め誤差
- 表現できる桁に切り詰めることで生じる誤差。
- 桁落ち
- 近い値の差を取って有効な桁が減る現象。
確認問題
確かめよう同じ平均の二つのデータでもばらつきは同じ?
いいえ。標準偏差などを併せて見ます。確率1/8の事象の情報量は3ビットです。
期待値は、1回の試行で必ずその値になる。
珍しい事象ほど情報量は大きい。
確率0.3で100円、0.7で0円の期待値は?
近い値の差を取って有効な桁が減る現象は?
データから判断するときは、平均だけでなくや偶然の影響を考えます。コンピュータの計算にも、有限の桁数で表すことによるがあります。
100円を受け取る確率が0.3、0円が0.7ならは100×0.3+0×0.7=です。これは一回必ず30円になるという意味ではなく、結果を確率で重み付けした値です。
分散は平均からのずれを二乗して平均した量で、はその平方根です。例えば2、4、6の平均は4、分散は{(−2)²+0²+2²}÷3=8/3、標準偏差は約1.63です。
標本から母集団を推測するときは、抽出の偏りと標本数を確認します。な二事象が両方起こる確率は積になりますが、独立でない場合にそのまま掛けてはいけません。
は表現できる桁に切り詰めることで生じ、は近い値の差を取って有効な桁が減る現象です。発生確率pの情報量は−log₂pビットで、珍しい事象ほど大きくなります。これらを単なるプログラムの誤記と混同しないようにします。
整列・再帰と計算量
整列とは、データを決まった順に並べ替える処理で、再帰や分割の仕方によって計算量が変わります。
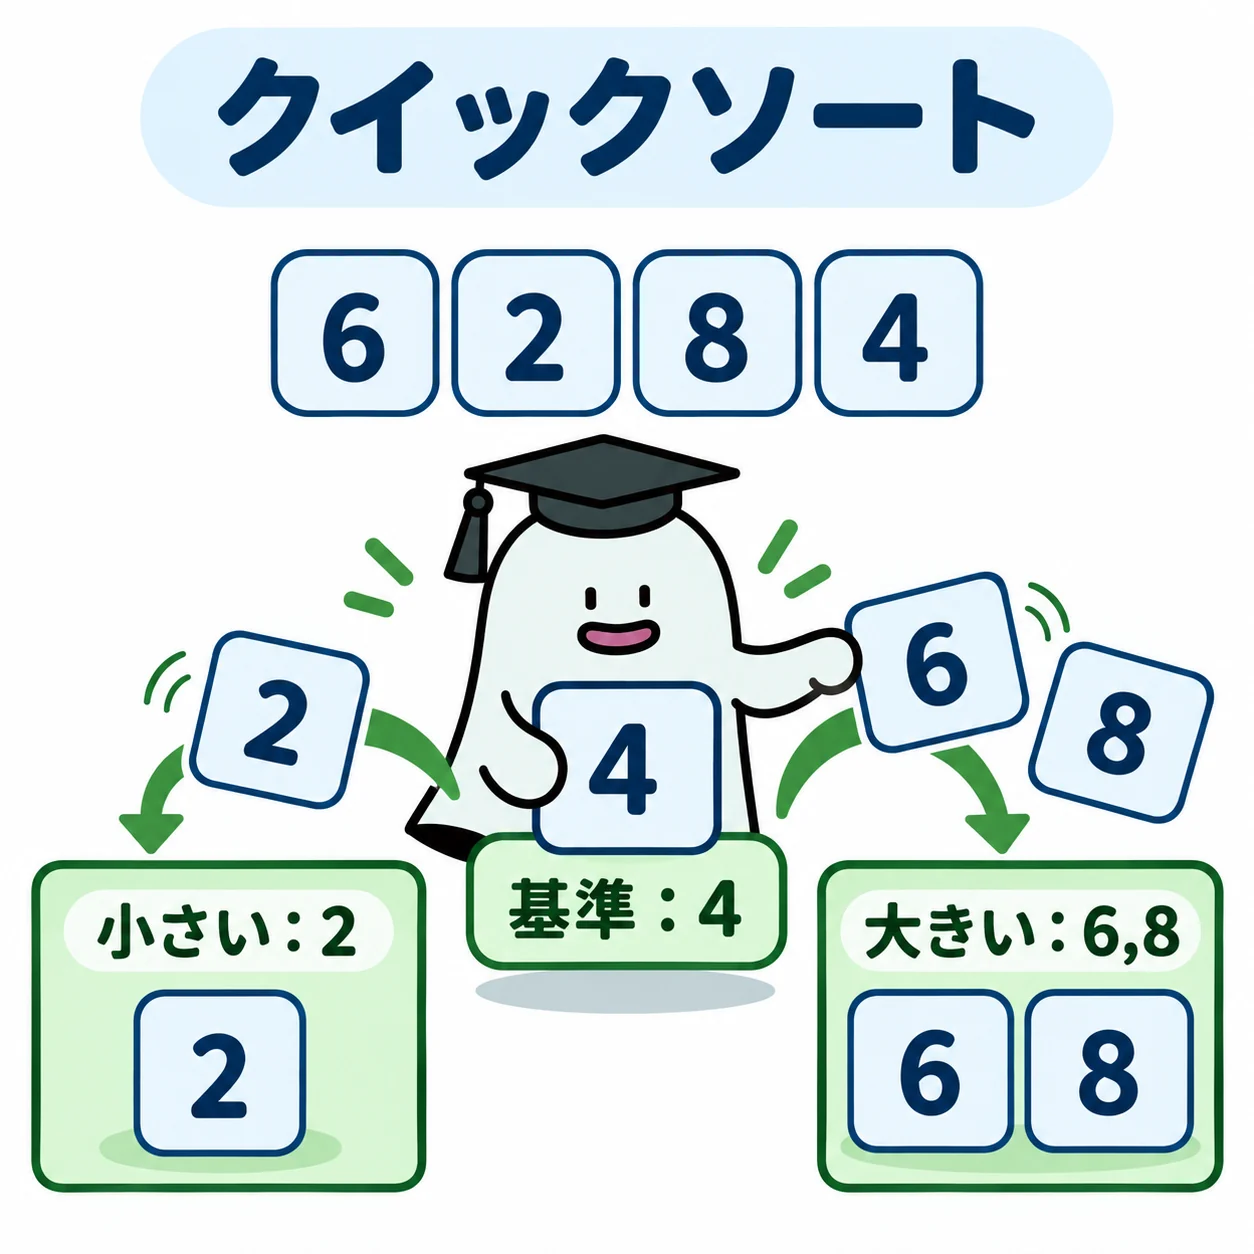
探索の前にデータを整列すると検索しやすくなりますが、整列自体にも処理時間が必要です。交換や分割の手順から、使うメモリと比較回数を考えます。
基本の仕組み
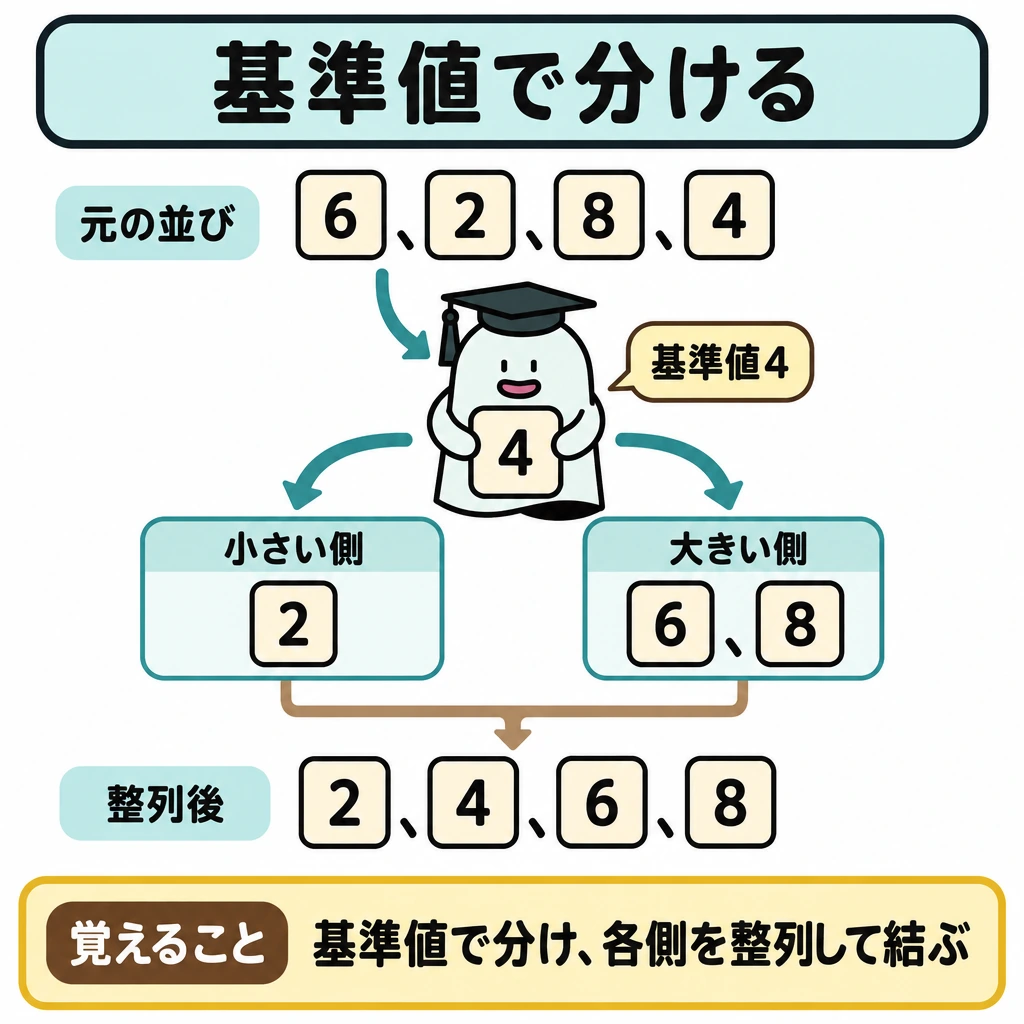
6、2、8、4を4を基準に分けると、小さい側は2、大きい側は6、8です。それぞれをさらに整列して結ぶと2、4、6、8になります。このように基準値で分割するのがクイックソートの考え方です。
クイックソートは平均的にはO(n log n)ですが、分割が極端に偏るとO(n²)になります。マージソートは部分列を整列して併合し、一般的な配列実装では作業領域を使います。バブルソートは隣接要素を比較・交換するため、多数の比較が必要です。
再帰は自分と同じ処理を小さい問題へ適用する方法です。階乗ならf(0)=1を終了条件にf(n)=n×f(n−1)とします。終了条件だけでなく、そこへ近づく引数の更新が必要で、呼出しの情報はスタックへ積まれます。
整列・再帰の費用
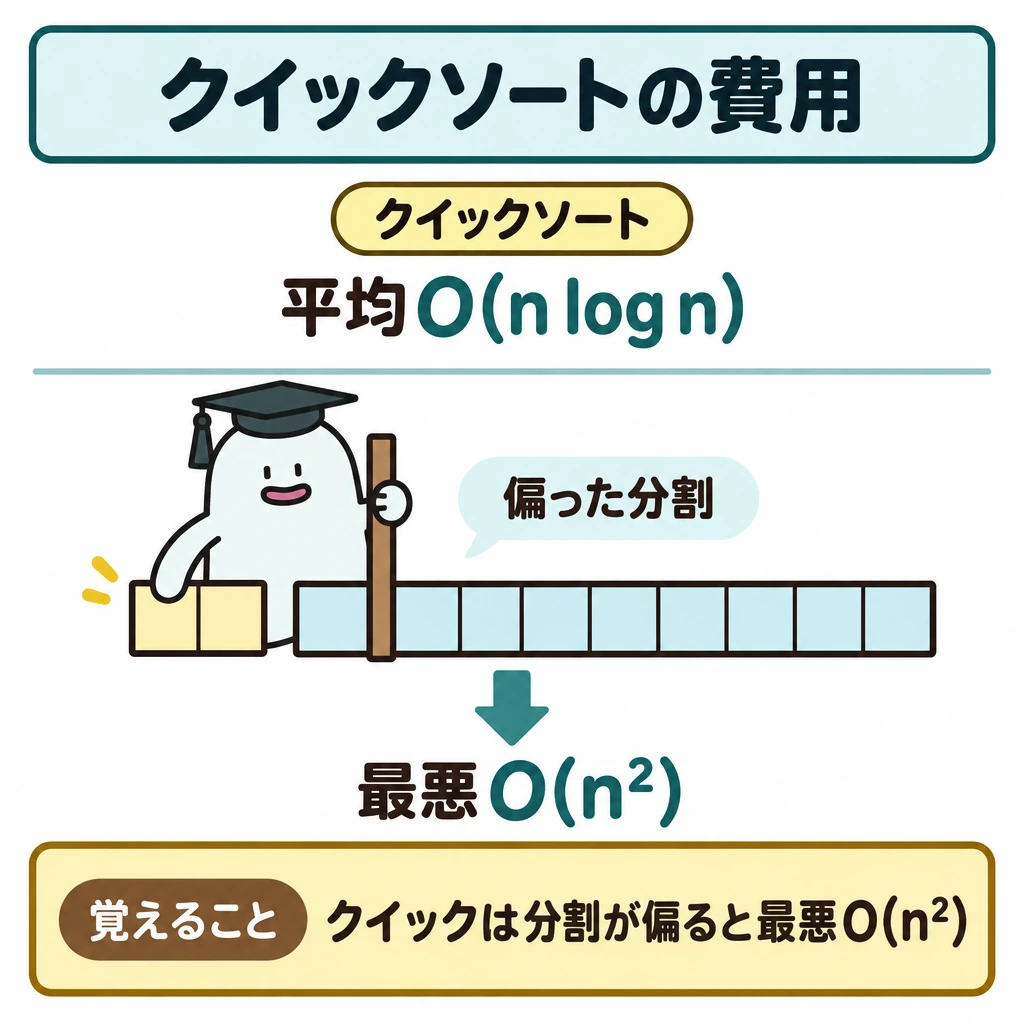
バブル・選択・挿入ソートは基本形の最悪計算量がO(n²)です。マージソートはO(n log n)で補助領域を使い、ヒープソートもO(n log n)です。クイックソートは平均O(n log n)でも、分割が偏ると最悪O(n²)です。再帰は停止条件と呼出しごとの状態を確認します。
| 方法 | 計算量の目安 |
|---|---|
| バブル・選択・挿入 | 最悪O(n²) |
| マージ | O(n log n) |
| ヒープ | O(n log n) |
| クイック | 平均O(n log n)、最悪O(n²) |
試験に出る
- クイックソートは平均O(n log n)だが分割が偏るとO(n²)。
- マージソートは併合で整列し、配列実装では作業領域を使う点。
- バブルソートは隣接比較・交換で比較回数が多いこと。
- 再帰は終了条件と、そこへ近づく引数の更新の両方が必要。
- 再帰呼出しの情報がスタックに積まれること。
重要な言葉
- クイックソート
- 基準値で分割しながら整列する方法。
- マージソート
- 部分列を整列して併合する方法。
- 再帰呼出し
- 自分と同じ処理をより小さい問題へ呼び出すこと。
- 計算量
- 処理に必要な手間を要素数との関係で表した量。
確認問題
確かめようクイックソートはどんな入力でもO(n log n)?
いいえ。分割の偏りによる最悪の場合と、平均的な場合を分けます。
クイックソートは、どの入力でも必ずO(n log n)である。
再帰には終了条件と、そこへ近づく引数の更新が必要。
分割が極端に偏るとO(n²)になる整列法は?
再帰呼出しの情報が積まれる場所は?
探索の前にデータを整列すると検索しやすくなりますが、整列自体にもが必要です。交換や分割の手順から、使うメモリとを考えます。
6、2、8、4を4を基準に分けると、小さい側は2、大きい側は6、8です。それぞれをさらに整列して結ぶと2、4、6、8になります。このようにで分割するのがの考え方です。
クイックソートは平均的にはO(n log n)ですが、分割が極端に偏るとO(n²)になります。は部分列を整列して併合し、一般的な配列実装では作業領域を使います。は隣接要素を比較・交換するため、多数の比較が必要です。
は自分と同じ処理を小さい問題へ適用する方法です。階乗ならf(0)=1をにf(n)=n×f(n−1)とします。終了条件だけでなく、そこへ近づく引数の更新が必要で、呼出しの情報はスタックへ積まれます。
単方向リストを配列でたどる
単方向リストとは、各要素が次の要素への参照だけを持つ構造で、配列の添字とは別に参照をたどります。
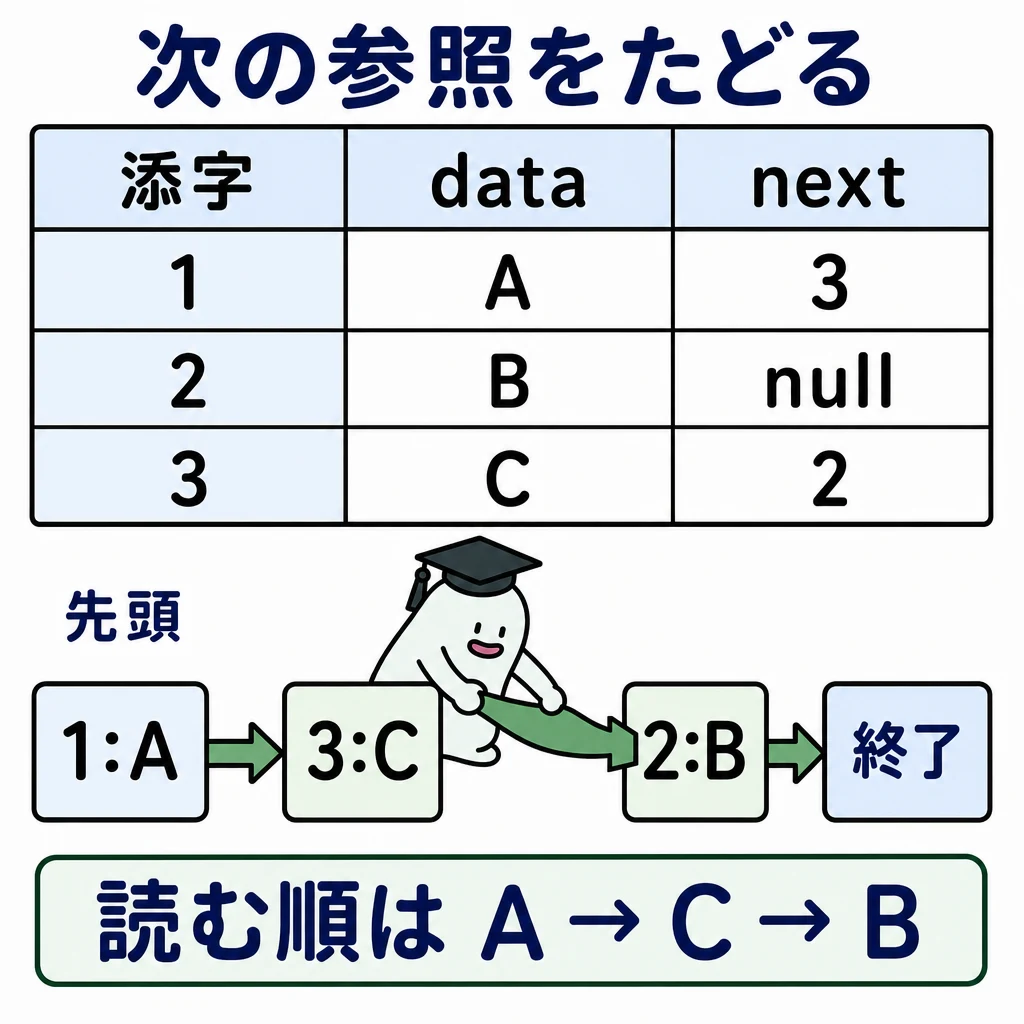
配列の添字順と、データを読む順番は同じとは限りません。単方向リストは、現在の要素が持つ「次の要素への参照」を頼りに進む構造です。
基本の仕組み
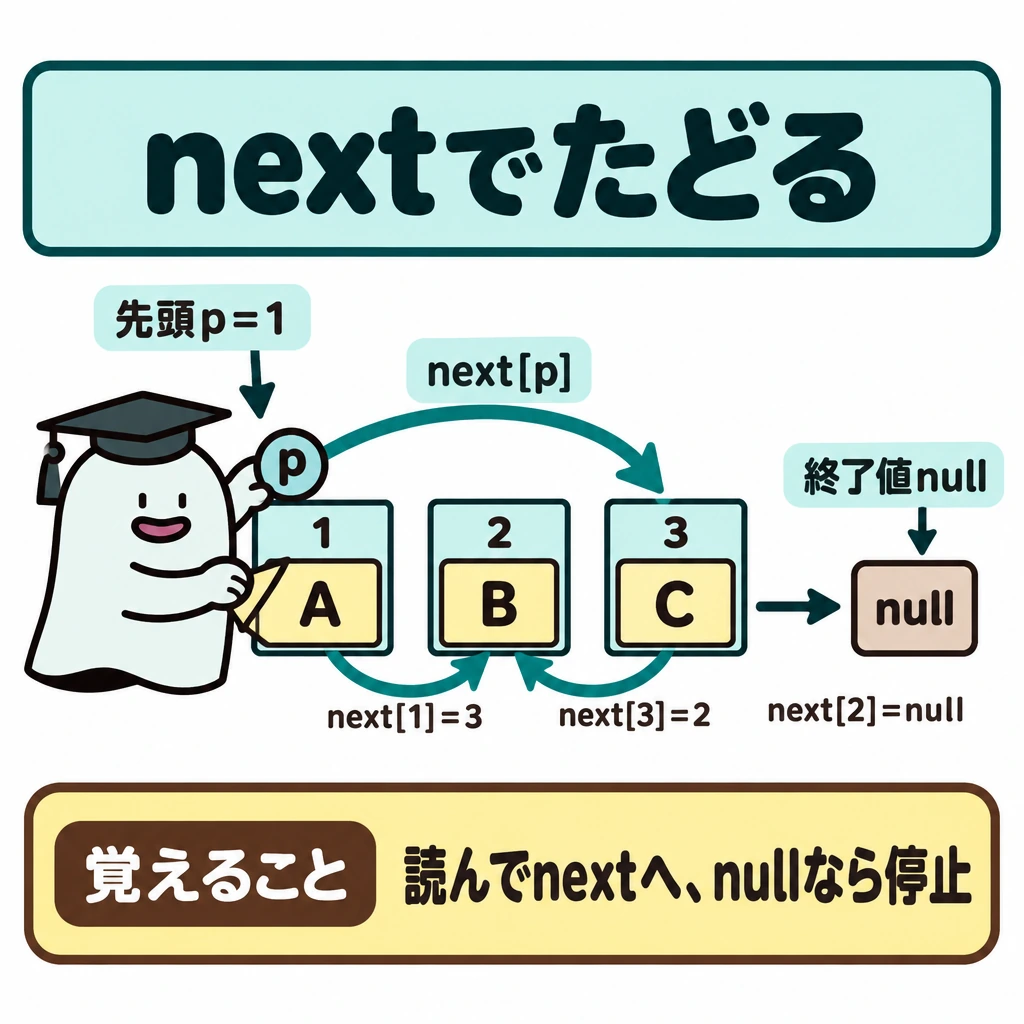
1始まりの例で、data[1]=A、data[2]=B、data[3]=C、next[1]=3、next[3]=2、next[2]=null、先頭が1なら、読む順はA→C→Bです。添字を1ずつ増やすのではなく、1→3→2とnextをたどります。
現在位置pのデータを読み、その後でp=next[p]へ更新します。pが終了を表す値になれば止めます。終了値が未定義(null)か0か、添字が0始まりか1始まりかは設問の定義に従い、終了値を配列の添字として参照しないようにします。
途中へ要素を挿入するときは参照の付け替えが必要です。ただし、走査の問題では挿入処理を勝手に追加しません。各反復の「更新前のp」「読んだdata[p]」「次のp」を表にすると、データ値と添字を混同しにくくなります。
配列によるリスト表現
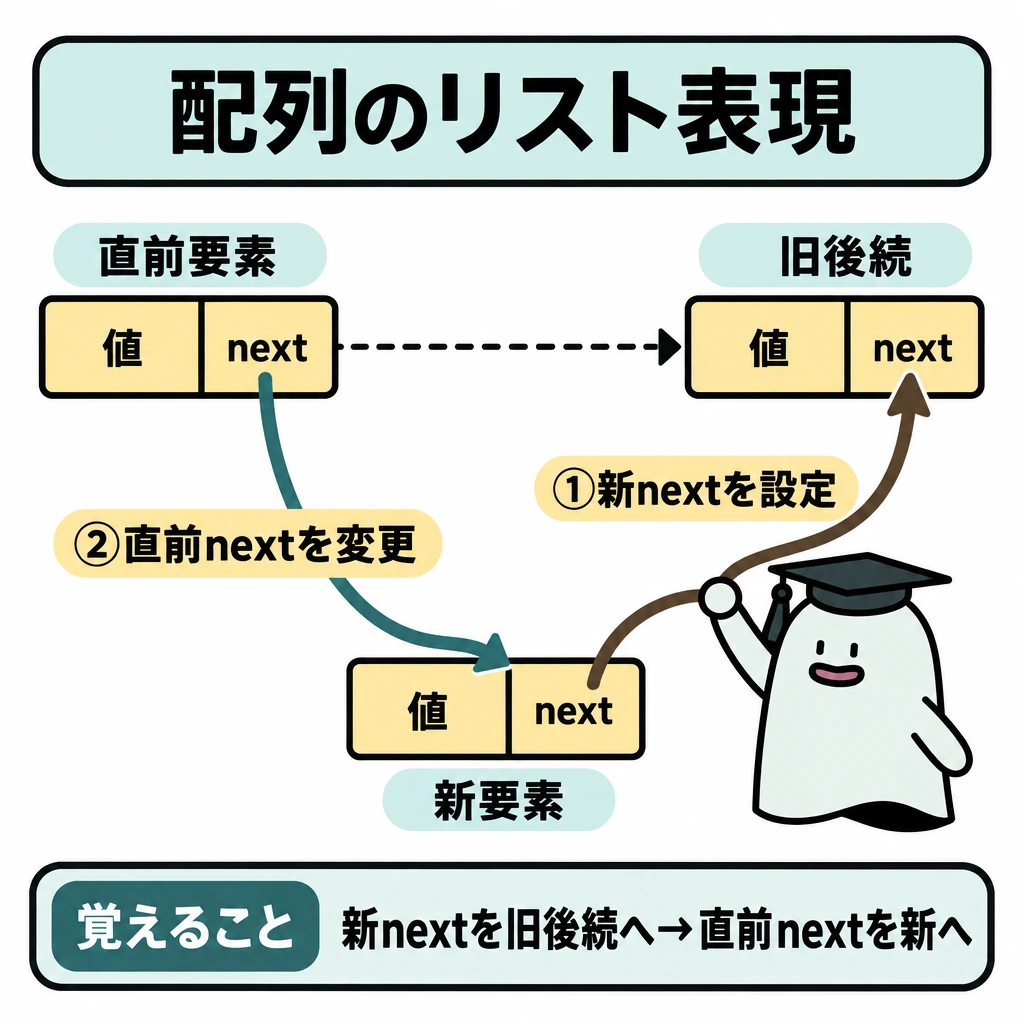
配列で単方向リストを表すときは、各要素の値だけでなく次要素の添字を保持します。先頭添字からnextをたどり、終端値で止めます。挿入では新要素のnextを旧後続へ設定してから、直前要素のnextを新要素へ変えます。
| 操作 | 更新する参照 |
|---|---|
| 走査 | 現在位置から次位置へ |
| 途中挿入 | 新要素と直前要素のnext |
| 削除 | 直前要素のnext |
試験に出る
- 配列の添字順ではなくnextをたどる読み順。
- data[p]を読んでからp=next[p]へ更新する順序。
- 終了値を配列の添字として参照しないこと。
- 0始まりか1始まりかを設問の定義で確認すること。
- データ値と添字、更新前と更新後のpを混同しないこと。
重要な言葉
- 単方向リスト
- 各要素が次の要素への参照だけを持つ構造。
- 添字
- 配列の要素を指定する番号。
- 終了値
- 走査の終わりを表す値。nullや0など設問の定義による。
- 走査
- 要素を順にたどって調べること。
確認問題
確かめようこの例でAを読んだ次にdata[2]を読む?
いいえ。next[1]=3なので、次はdata[3]のCです。
単方向リストは、配列の添字を1ずつ増やして読む。
終了を表す値を、配列の添字として参照してよい。
data[1]=A、next[1]=3のとき、Aの次に読むのは?
単方向リストの走査でpを更新する正しい順序は?
配列の添字順と、データを読む順番は同じとは限りません。は、現在の要素が持つ「次の要素への」を頼りに進む構造です。
1始まりの例で、data[1]=A、data[2]=B、data[3]=C、[1]=3、next[3]=2、next[2]=null、先頭が1なら、読む順はです。添字を1ずつ増やすのではなく、1→3→2とnextをたどります。
のデータを読み、その後でp=next[p]へ更新します。pが終了を表す値になれば止めます。終了値が未定義(null)か0か、添字が0始まりか1始まりかは設問の定義に従い、を配列の添字として参照しないようにします。
途中へ要素を挿入するときはが必要です。ただし、走査の問題では挿入処理を勝手に追加しません。各反復の「」「読んだdata[p]」「次のp」を表にすると、データ値と添字を混同しにくくなります。
AND・ORと真理値表の逆算
AND・ORとは、二つ以上の条件を組み合わせる論理演算で、真理値表を使えば入力や出力を逆算できます。
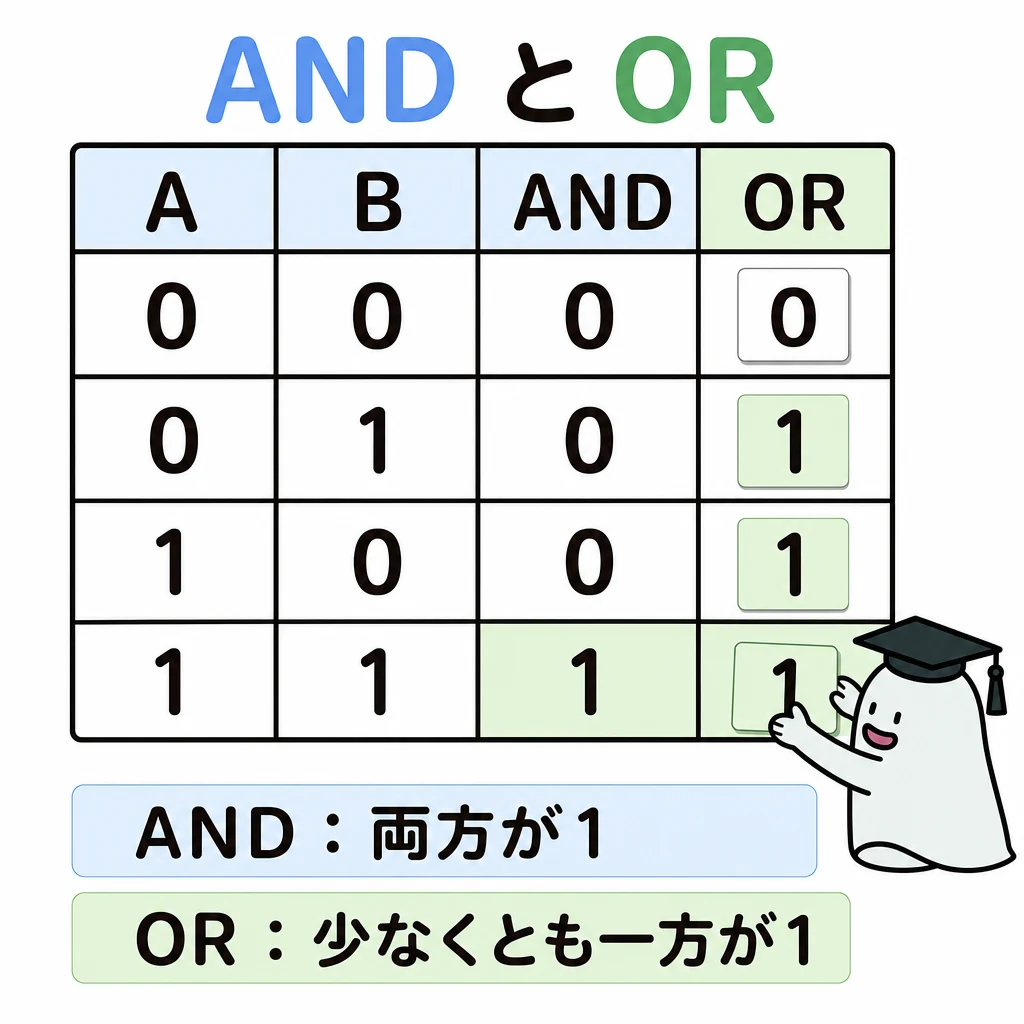
二つの条件の両方が必要なのか、どちらか一つでよいのかで結果が変わります。論理演算では、まず0と1の全組合せを表にして確かめます。
基本の仕組み
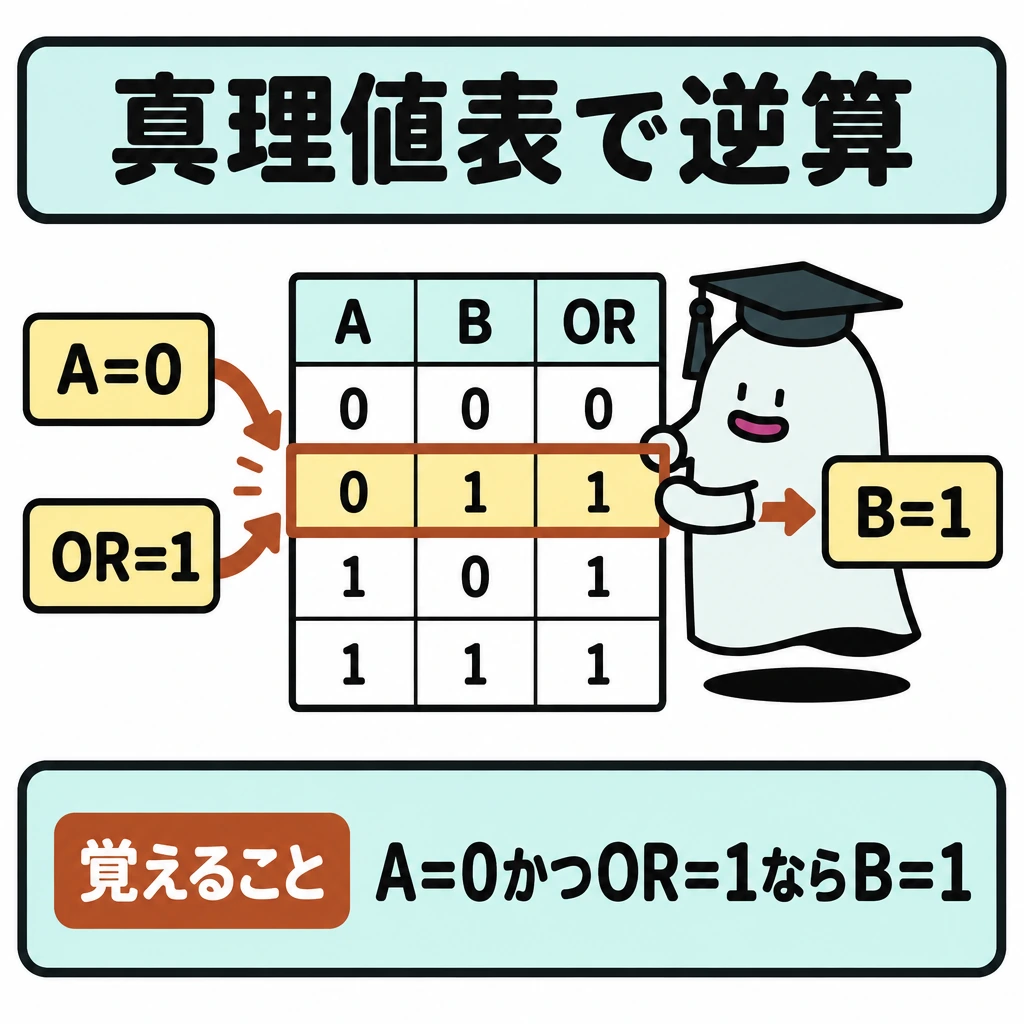
入力(A,B)が(0,0)、(0,1)、(1,0)、(1,1)の順なら、ANDの出力は0、0、0、1、ORの出力は0、1、1、1です。ANDは両方が1のときだけ1、ORは少なくとも一方が1なら1になります。
出力から未知の入力を逆算する場合も、同じ表を使います。A=0でA OR B=1ならB=1です。A=1でA AND B=0ならB=0です。既知の入力と出力の両方に合う行だけを残します。
いつでも未知の値が一つに決まるわけではありません。A=0でA AND B=0なら、Bは0でも1でも成立します。また、ORを「どちらか一方だけ」と覚えると、両方が1の行を間違えます。それはXORとの混同です。
演算の比較とド・モルガンの法則
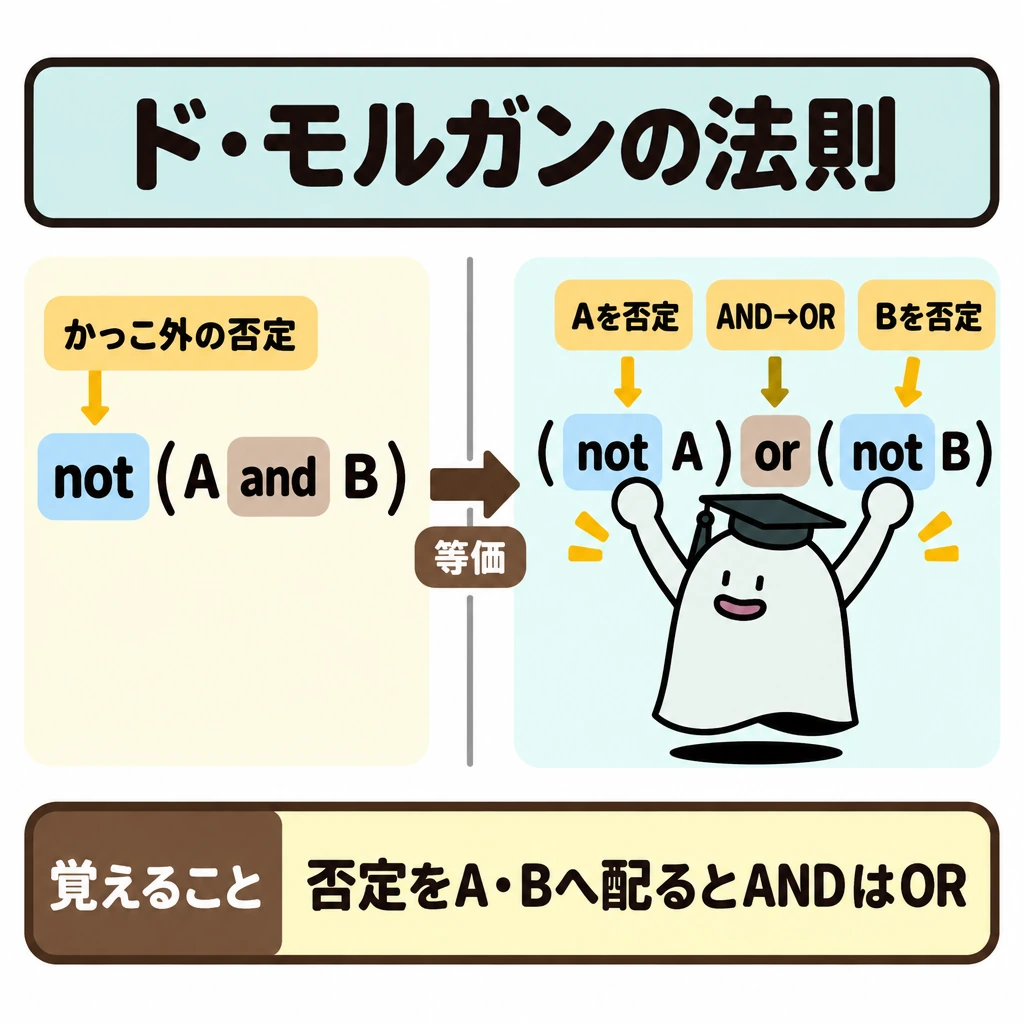
ANDは両方真、ORは少なくとも一方が真、XORは異なるとき真、NANDはANDの否定です。論理式が等価かを確かめるときは、入力の全組合せの出力を比較します。
否定をかっこの中へ配るときは、ド・モルガンの法則でANDとORも入れ替えます。not (A and B) は (not A) or (not B)、not (A or B) は (not A) and (not B) と等しくなります。
| 演算 | 1となる条件 |
|---|---|
| AND | 両方1 |
| OR | 少なくとも一方1 |
| XOR | 二つが異なる |
| NAND | 両方1以外 |
試験に出る
- ANDは両方1のときだけ1、ORは一方が1なら1という違い。
- 真理値表から未知の入力を逆算する手順。
- 出力が同じでも入力が確定しない場合があること。
- ORを「どちらか一方だけ」と覚えるとXORと混同すること。
- 入力と出力の両方に合う行だけを残す考え方。
重要な言葉
- 真理値表
- 入力の全組合せと出力を並べた表。
- AND
- 両方の入力が1のときだけ1になる論理演算。
- OR
- 少なくとも一方の入力が1なら1になる論理演算。
- XOR
- 二つの入力が異なるとき1になる論理演算。
確認問題
確かめようA=1でA OR B=1ならBを確定できる?
できません。Bが0でも1でも出力が1になるからです。
ANDは、少なくとも一方の入力が1なら1になる。
A=0でA AND B=0のとき、Bは0でも1でも成立する。
A=0でA OR B=1のとき、Bは?
「どちらか一方だけが1のとき1」となる論理演算は?
二つの条件の両方が必要なのか、どちらか一つでよいのかで結果が変わります。では、まず0と1のを表にして確かめます。
入力(A,B)が(0,0)、(0,1)、(1,0)、(1,1)の順なら、の出力は0、0、0、1、の出力は0、1、1、1です。ANDは両方が1のときだけ1、ORは少なくとも一方が1なら1になります。
出力から未知の入力をする場合も、同じ表を使います。A=0でA OR B=1ならB=1です。A=1でA AND B=0ならB=0です。と出力の両方に合う行だけを残します。
いつでも未知の値が一つに決まるわけではありません。A=0でA AND B=0なら、Bは0でも1でも成立します。また、ORを「どちらか一方だけ」と覚えると、両方が1の行を間違えます。それはとのです。
覚えるポイント
- 基礎理論:nビットの2の補数表現の範囲は −(2^(n−1)) から 2^(n−1)−1 です。8ビットでは−128から127です。論理演算は各ビットの真偽で扱い、数値の加算とは区別します。
- データ構造:配列は添字で直接要素を参照しやすく、連結リストは次の要素への参照をたどります。木は親子関係を持ち、根から枝を選んで要素を探せます。
- アルゴリズム:二分探索は整列を前提とし、比較のたびに下限または上限を更新します。候補を約半分にするため、探索の比較回数は要素数nに対しておおむねlog₂nの規模です。
- 疑似言語と科目B読解:条件分岐は条件を評価した時点の値で進む先が決まり、反復では終了条件を再評価します。配列の走査では、添字がどこからどこまで動くかを先に確認します。
- 確率・統計と数値誤差:分散は平均からのずれを二乗して平均した量で、標準偏差はその平方根です。標本から母集団を推測するときは、抽出の偏りと標本数を確認します。独立な二事象が両方起こる確率は積になりますが、独立でない場合にそのまま掛けてはいけません。
- 整列・再帰と計算量:クイックソートは平均的にはO(n log n)ですが、分割が極端に偏るとO(n²)になります。マージソートは部分列を整列して併合し、一般的な配列実装では作業領域を使います。バブルソートは隣接要素を比較・交換するため、多数の比較が必要です。
- 単方向リストを配列でたどる:単方向リストとは、各要素が次の要素への参照だけを持つ構造で、配列の添字とは別に参照をたどります。
- AND・ORと真理値表の逆算:AND・ORとは、二つ以上の条件を組み合わせる論理演算で、真理値表を使えば入力や出力を逆算できます。
出典・参考資料
試験の公式案内と、この記事の参考にした学習資料です。
編集:Pinternet Works · 更新日:
教材の編集方針・訂正について