

旧制度の午前・午後と、2023年度以降の科目A・科目Bの公開問題を区別しています。現在の試験対策では現行シラバスと科目Bの形式を確認してください。公開問題は本試験の全出題を網羅する資料ではありません。
2025年度 科目A 公開問題の概要
大規模言語モデルのファインチューニング
テクノロジ系 · 人工知能 / 自然言語処理 / 大規模言語モデル
大規模言語モデル(LLM)を用いた自然言語処理において、事前学習済みのモデルに対して実施する「ファインチューニング」に関する説明として、最も適切なものはどれか。
解答・解説を表示
解答
エ
解説
まず要点:ファインチューニング(微調整)とは、学習済みのモデルに特定の目的のデータを足して学び直させることです。大量の文章で作った土台のモデルに、専門分野や決まった仕事のデータを追加で覚えさせます。そうすると、その目的の作業に使えるようになります。
解き方
- まず、学習済みモデルが一般的な言葉の特徴をすでに持っていることを確認します。
- 医療の質問応答や要約など、決まった作業に合わせるための追加学習だと説明する選択肢を選びます。
- 選択肢 ア不正解
- 強化学習で最適化することはありますが、それはファインチューニング全体の意味ではありません。
- 選択肢 イ不正解
- 同じデータを繰り返すのではなく、目的に合わせた新しいデータで追加学習します。
- 選択肢 ウ不正解
- 大量の文章で一般的な言葉の知識を覚えさせるのは「事前学習」の説明です。
- 選択肢 エ正解
- 学習済みモデルに特定の用途のデータを追加で学ばせ、目的の作業に合わせる正しい説明です。
覚えるポイント
- 事前学習=大量の汎用データで基礎知識を学ぶ
- ファインチューニング=特定用途のデータで追加学習して特化させる
間違えやすいところ
- 一般的な知識を覚えさせる「事前学習」と、特定の作業に合わせる「ファインチューニング」を混同しないようにします。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 AI技術・自然言語処理)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.2 ↗(www.ipa.go.jp)
浮動小数点演算における丸め誤差
テクノロジ系 · 基礎理論 / 数値表現 / 誤差の種類
浮動小数点形式で表現された数値の演算結果における「丸め誤差」の説明として、適切なものはどれか。
解答・解説を表示
解答
イ
解説
まず要点:丸め誤差とは、コンピュータが数値を決まったけた数でしか表せないために、はみ出した端を四捨五入などして生じるずれです。コンピュータの中の浮動小数点数(小数を表す形式)は、使えるけた数に限りがあります。そのため表せない細かい部分を切り捨てたり四捨五入したりし、本当の値との差が出ます。
解き方
- コンピュータが表せる小数の有効けた数には限りがあることを押さえます。
- 表せるけた数より下を四捨五入や切上げ・切捨てすることで生じる誤差を「丸め誤差」と見分けます。
- 選択肢 ア不正解
- 演算結果が扱える最大値を超えてしまう現象は「桁あふれ誤差(オーバーフロー)」です。
- 選択肢 イ正解
- 表せるけた数に限りがあるため、最下位のけたより下を四捨五入や切上げ・切捨てして生じる誤差で、丸め誤差の正しい説明です。
- 選択肢 ウ不正解
- 指数の小さい数の下位部分が失われる現象は「情報落ち」です。
- 選択肢 エ不正解
- 絶対値がほぼ等しい数の引き算で有効な数字が減ってしまう現象は「桁落ち」です。
関連する分野を学ぶ
覚えるポイント
- 丸め誤差:四捨五入や切り捨てなどの端数処理で生じる
- 情報落ち:大小差が大きい加減算で小さい方の下位が消失
- 桁落ち:ほぼ等しい数の引き算で有効数字が激減
間違えやすいところ
- 情報落ち・桁落ち・丸め誤差は似ているので、起きる原因(端の処理・絶対値の差・引き算)で区別して覚えます。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 離散数学・数値計算)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.2 ↗(www.ipa.go.jp)
2分探索木の大小関係
テクノロジ系 · データ構造 / 木構造 / 2分探索木
根をaとし、左の子をb、右の子をcとし、さらにbの左の子をd、右の子をe、cの左の子をf、右の子をgとする2分探索木がある。各節点a~gの値が重複しないとき、これらの値の大小関係として適切なものはどれか。
解答・解説を表示
解答
イ
解説
まず要点:2分探索木(値を大小で並べて入れる木)では、どの節点でも「左側の全部の値 < その節点の値 < 右側の全部の値」が成り立ちます。このきまりに従うと、左→根→右の順(通りがけ順)でたどったときに値が小さい順に並びます。
解き方
- 与えられた木の形(根a、左側b・d・e、右側c・f・g)を確かめます。
- 左側は「d<b<e」、右側は「f<c<g」の関係になることを整理します。
- 左側<根a<右側を合わせて「d<b<e<a<f<c<g」を導きます。
- 選択肢 ア不正解
- 根のaが一番小さく、左側のb・d・eがaより大きいので、2分探索木のきまりに反します。
- 選択肢 イ正解
- 左側(d<b<e)<根a<右側(f<c<g)となり、小さい順に正しく並んでいます。
- 選択肢 ウ不正解
- 葉の節点が先に来ており、2分探索木の大小のきまりを満たしていません。
- 選択肢 エ不正解
- 右から左への降順にもなっておらず、誤りです。
覚えるポイント
- 2分探索木を「左→親→右」(通りがけ順/中順巡回)で巡回すると必ず昇順になる
間違えやすいところ
- 幅優先探索や親→左→右の順と混同してアを選ばないようにします。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 アルゴリズムとデータ構造)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.3 ↗(www.ipa.go.jp)
MTBFとMTTRの改善に伴う稼働率の計算
テクノロジ系 · システム構成要素 / システムの評価指標 / 稼働率の計算
MTBFが4,000時間、MTTRが1,000時間の装置がある。今後の6年間、予防保守によってMTBFを前年に比べて毎年100時間ずつ改善(増加)し、遠隔保守によってMTTRを前年に比べて毎年100時間ずつ改善(短縮)していく計画である。6年経過後の稼働率は幾らか。
解答・解説を表示
解答
ウ
解説
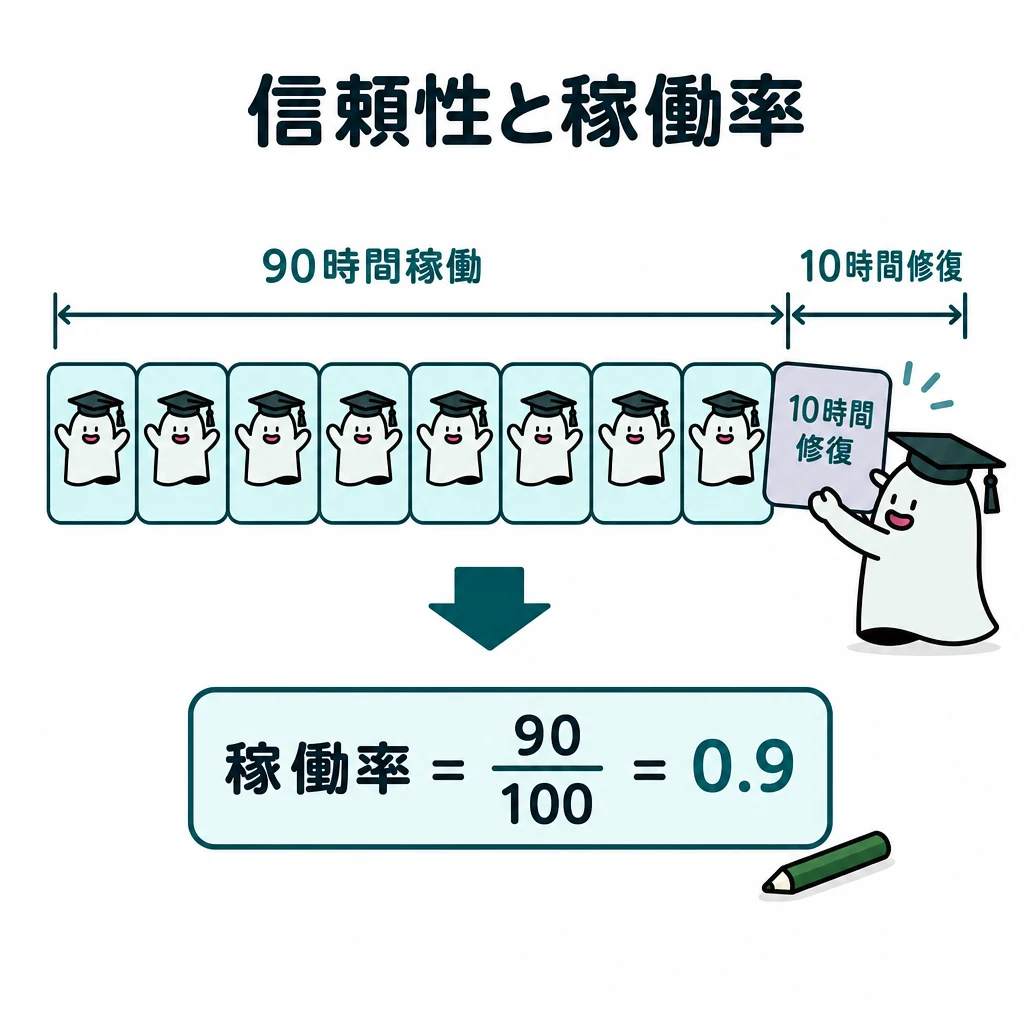
まず要点:稼働率は「MTBF ÷(MTBF + MTTR)」で求めます。MTBF(平均故障間隔)は壊れずに動く平均時間、MTTR(平均修復時間)は直すのにかかる平均時間です。MTBFを伸ばすほど、またMTTRを短くするほど稼働率は上がります。
解き方
- 6年後のMTBFを求めます:4,000+(100×6)=4,600時間。
- 6年後のMTTRを求めます:1,000-(100×6)=400時間(改善は短縮)。
- 稼働率の式に入れます:4,600÷(4,600+400)=4,600÷5,000=0.92。
- 選択肢 ア不正解
- 最初の状態の稼働率 4,000÷5,000=0.80 などをもとにした誤った計算です。
- 選択肢 イ不正解
- MTTRの改善を考えずMTBFだけを伸ばした場合(4,600÷5,600≒0.82)などの誤りです。
- 選択肢 ウ正解
- 6年後はMTBF=4,600時間、MTTR=400時間なので、4,600÷5,000=0.92となり正解です。
- 選択肢 エ不正解
- 年数や改善量を大きく見積もりすぎた誤りです。
関連する分野を学ぶ
覚えるポイント
- 稼働率 = MTBF ÷ (MTBF + MTTR)
- MTBFの改善=時間の増加、MTTRの改善=時間の減少(短縮)
間違えやすいところ
- 「MTTRの改善」を増加と取り違えて1,000+600=1,600時間としないようにします。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 システムの信頼性)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.3 ↗(www.ipa.go.jp)
ローコード開発ツールの特徴
テクノロジ系 · システム開発技術 / ソフトウェア開発手法 / ローコード開発
ローコード開発ツールを用いたソフトウェア開発の説明として、適切なものはどれか。
解答・解説を表示
解答
ア
解説
まず要点:ローコード開発とは、画面操作で部品を組み合わせて作り、足りない部分だけコードを書く開発方法です。GUI(画面上の操作)を使い、ドラッグ&ドロップなどで多くの機能を作ります。複雑な処理だけ、必要最小限のソースコードで補います。コードを一切書かない方法は「ノーコード」と呼びます。
解き方
- 「ローコード(少しコードを書く)」と「ノーコード(コードを書かない)」の違いに注目します。
- GUI部品を組み合わせ、必要ならコードも書く選択肢アを見つけます。
- 選択肢 ア正解
- GUIで部品を組み合わせるのを基本にし、必要な所だけコードを書く開発で、ローコード開発の正しい説明です。
- 選択肢 イ不正解
- コードをまったく書かず画面操作だけで作るのは「ノーコード開発」の説明です。
- 選択肢 ウ不正解
- フレームワークなどを使い一からコードを書く、従来の開発の説明です。
- 選択肢 エ不正解
- 利用者の定型的なPC操作を記録して代行させる「RPA」の説明です。
覚えるポイント
- ローコード:GUI操作中心+必要な部分だけ最小限のコーディング
- ノーコード:プログラミング不要(一切コードを書かない)
- RPA:PC操作の自動化
間違えやすいところ
- ローコード(一部記述できる)とノーコード(記述不要)を混同しないようにします。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 ソフトウェア開発手法)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.4 ↗(www.ipa.go.jp)
SQLにおけるIN述語と同等なSELECT文
テクノロジ系 · データベース / SQL / 問合せ言語
“商品”表に対するSQL文「SELECT * FROM 商品 WHERE 仕入先 ID IN ('M002', 'M004')」と同じ結果が得られるSELECT文はどれか。
解答・解説を表示
解答
ウ
解説
まず要点:SQLのIN述語は、列の値が並べた候補のどれか1つに一致するかを調べるものです。これは「=候補1 または =候補2」をOR(または)でつないだ条件と同じ意味になります。
解き方
- 「WHERE 仕入先ID IN ('M002','M004')」の意味を読み取ります(仕入先IDがM002またはM004)。
- 「='M002' OR ='M004'」が同じ結果になることを確かめます。
- 選択肢 ア不正解
- 同じ列が同時に2つの値になることはないので、ANDでつなぐと結果は必ず0件になります。
- 選択肢 イ不正解
- INTERSECTは共通部分を求めるので、仕入先IDがM002かつM004の行を探すことになり0件になります。
- 選択肢 ウ正解
- IN述語は候補のどれかに一致すれば真なので、ORで書いたこの選択肢と同じ結果になります。
- 選択肢 エ不正解
- BETWEENは範囲(以上かつ以下)を表すので、'M003'など間の値も含まれ結果が変わります。
関連する分野を学ぶ
覚えるポイント
- 列 IN (値1, 値2) ≡ (列 = 値1 OR 列 = 値2)
- BETWEENは範囲比較(以上かつ以下)なので離散値の列挙にはならない
間違えやすいところ
- 日常会話の「M002とM004」につられてANDを選ばないようにします。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 データベース言語)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.5 ↗(www.ipa.go.jp)
通信回線の利用率の計算
テクノロジ系 · ネットワーク / 通信プロトコル / 伝送時間と回線利用率
1Gバイトの動画データを40Mビット/秒の回線を使用してダウンロードしたところ、5分掛かった。このときの回線利用率はおよそ何%か。ここで、ダウンロード時には動画データに20%の制御情報が付加されるものとし、1G=10^9、1M=10^6とする。
解答・解説を表示
解答
エ
解説
まず要点:回線利用率は「実際に流したデータ量 ÷ その時間に流せる最大量 ×100」で求めます。バイトは8ビットに直す必要があります。また制御情報(データに付け足される情報)の分も足して考えます。
解き方
- 流した総ビット数を求めます:1Gバイト=8,000Mビット。制御情報20%を足して8,000×1.2=9,600Mビット。
- 5分(300秒)で流せる最大量を求めます:40Mビット/秒×300秒=12,000Mビット。
- 回線利用率を計算します:9,600÷12,000=0.80(80%)。
- 選択肢 ア不正解
- バイトをビットに8倍する換算をせずに計算した場合に近い誤りです。
- 選択肢 イ不正解
- 計算の手順を間違えたための不適切な数値です。
- 選択肢 ウ不正解
- 制御情報の20%増を忘れて8,000÷12,000≒67%とした誤りです。
- 選択肢 エ正解
- 総データ量9,600Mビットを5分間の最大量12,000Mビットで割ると80%となり正解です。
覚えるポイント
- 1バイト = 8ビット(単位を必ずビットに統一する)
- 回線利用率 = 実伝送データ量 ÷ (回線速度 × 所要秒数)
間違えやすいところ
- 「制御情報が20%付く」の条件を忘れて1.2倍し忘れ、67%(ウ)を選びがちです。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 ネットワークの性能)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.5 ↗(www.ipa.go.jp)
HTTPSの特徴とサーバ証明書
テクノロジ系 · セキュリティ / 通信セキュリティ / TLS/HTTPS
HTTPとHTTPSを比較した場合において、HTTPSだけがもつ特徴を示したものはどれか。
解答・解説を表示
解答
エ
解説
まず要点:HTTPSだけが持つ特徴は、サーバ証明書で通信相手のサーバを確かめられることです。HTTPSはHTTPの通信をTLSで暗号化して守ります。これにより通信の盗み見を防ぎ、改ざんを見つけ、相手が本物かどうかを証明書で確認できます。
解き方
- 各選択肢の機能がHTTPでも使えるか、TLSの機能が必要かを判断します。
- サーバ証明書でサーバを認証する(なりすまし防止)のはHTTPS特有の機能だと見分けます。
- 選択肢 ア不正解
- Cookieを使ったセッション管理はHTTPの機能で、HTTPでもHTTPSでも同じように使えます。
- 選択肢 イ不正解
- IDとパスワードによる認証はHTTPでもでき、違うのは通信が暗号化されるかどうかだけです。
- 選択肢 ウ不正解
- WebブラウザのキャッシュはHTTPヘッダに基づくので、通常のHTTPでも働きます。
- 選択肢 エ正解
- 信頼できる機関(CA)が発行したサーバ証明書を確かめ、相手のなりすましを防ぐのはHTTPS独自の特徴です。
関連する分野を学ぶ
覚えるポイント
- HTTPSの3大機能:盗聴防止(暗号化)、改ざん検知(メッセージ認証コード)、なりすまし防止(サーバ証明書による認証)
間違えやすいところ
- CookieやID・パスワードによる認証はHTTPS固有ではなく、HTTPでも普通に使われる点に注意します。
出題の前提:令和7年度基本情報技術者試験科目A公開問題(シラバスVer.9.0 ネットワークセキュリティ)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.6 ↗(www.ipa.go.jp)
暗号技術の危殆化
セキュリティ · 暗号アルゴリズムの危殆化 / ハッシュ関数の衝突耐性
暗号の危殆化(きたいか)に該当するものとして、適切なものはどれか。
解答・解説を表示
解答
ウ
解説
まず要点:暗号の危殆化とは、暗号のしくみ自体が弱くなって安全でなくなることです。鍵が漏れるなどの事故ではなく、コンピュータの高性能化や新しい解読方法の発見によって、その暗号が使えなくなる状態をいいます。
解き方
- 暗号の「危殆化」が、鍵の漏えいではなく、しくみや鍵長そのものの安全性が下がることを指すと確認する。
- 個別の鍵漏えいや運用ミスではなく、アルゴリズムの弱点が見つかった選択肢を選ぶ。
- 選択肢 ア不正解
- 証明書の有効期限切れは管理のミスであり、暗号のしくみ自体が弱くなったわけではないので該当しません。
- 選択肢 イ不正解
- 秘密鍵が不正アクセスで漏れたのは個別の事故であり、暗号アルゴリズムそのものが弱くなったわけではありません。
- 選択肢 ウ正解
- 同じハッシュ値になる別のデータを現実的な時間で見つけられるようになったのは、暗号の安全性が失われた危殆化です。
- 選択肢 エ不正解
- ランサムウェアの復号鍵が公開されたのは被害からの回復であり、暗号アルゴリズムが弱くなったことではありません。
覚えるポイント
- 危殆化はアルゴリズムや十分な鍵長の安全性が学術的・計算力的に破られること
- ハッシュ値の衝突が現実的時間で発見可能になることは強衝突耐性の危殆化
間違えやすいところ
- 個別の秘密鍵漏えい事故と、暗号のしくみそのものの危殆化を混同しやすい
出題の前提:公開問題の出題基準および暗号アルゴリズムの安全性評価基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.6 ↗(www.ipa.go.jp)
WAF(Web Application Firewall)の機能と特徴
セキュリティ · WAF / Webアプリケーションセキュリティ
WAF(Web Application Firewall)の説明として、適切なものはどれか。
解答・解説を表示
解答
ア
解説
まず要点:WAFは、Webサイトへの通信の中身を見て、攻撃とみられるものを検知してブロックする装置です。普通のファイアウォールでは通してしまうHTTPリクエストの中まで調べ、Webアプリの弱点を狙う攻撃を防ぎます。
解き方
- WAFが守る対象がWebアプリケーションの層であり、その動き方を思い出す。
- Web通信の中身を解析し、悪意あるパターンを検知・遮断する説明を選ぶ。
- 選択肢 ア正解
- Webへのアクセス内容を調べ、攻撃パターンを見つけたら遮断するという説明で、WAFの正しい説明です。
- 選択肢 イ不正解
- Wi-Fiアライアンスが認定した無線LANの暗号化規格はWPA2やWPA3のことで、WAFではありません。
- 選択肢 ウ不正解
- いろいろなログを一か所に集めて分析する仕組みはSIEMの説明で、WAFではありません。
- 選択肢 エ不正解
- 複数のセキュリティ機能をまとめて管理する仕組みはUTMの説明で、WAFではありません。
関連する分野を学ぶ
覚えるポイント
- WAFはアプリケーション層(L7)でHTTPリクエストの中身を検査する
- ネットワーク型ファイアウォールでは防げないWebアプリ脆弱性攻撃(SQLiやXSS)に対応する
間違えやすいところ
- 統合脅威管理のUTMやログ分析のSIEMと、WAFの役割を混同しないこと
出題の前提:公開問題の出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.6 ↗(www.ipa.go.jp)
E-Rモデルにおけるエンティティの特徴
データベース · E-Rモデル / エンティティと属性
E-Rモデルにおけるエンティティの特徴として、適切なものはどれか。
解答・解説を表示
解答
ウ
解説
まず要点:E-Rモデルでは、エンティティは属性(アトリビュート)を持ちます。エンティティは「顧客」や「注文」のような対象を表し、その特徴を表すのが属性です。
解き方
- E-Rモデルを作る基本の要素であるエンティティ、属性、関連を整理する。
- エンティティが属性を持ち、1つの型に対して複数のインスタンスがあることを確認する。
- 選択肢 ア不正解
- エンティティは型であり、その具体的な中身であるインスタンスは複数あるので、1対1ではありません。
- 選択肢 イ不正解
- エンティティには「顧客」のような実物だけでなく、「注文」のような概念も含まれます。
- 選択肢 ウ正解
- エンティティは自分の特徴を表す属性を1つ以上持つので、この説明は正しいです。
- 選択肢 エ不正解
- エンティティ同士の関係はリレーションシップで表し、状態遷移で表すのはステートマシン図などです。
覚えるポイント
- エンティティは属性(アトリビュート)の集まりで構成される
- 物理的なモノだけでなく概念や取引イベントもエンティティになる
間違えやすいところ
- 「実体」という言葉から、物理的に存在するものだけだと誤解しやすい
出題の前提:公開問題の出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.7 ↗(www.ipa.go.jp)
オブジェクト指向における多相性(ポリモーフィズム)
ソフトウェア開発 · オブジェクト指向 / 多相性 / ポリモーフィズム
オブジェクト指向プログラミングの特徴のうち,異なるクラスのオブジェクトを同一のインタフェースで操作したときに,操作対象クラスに応じた異なる動作を可能にすることを何と呼ぶか。
解答・解説を表示
解答
エ
解説
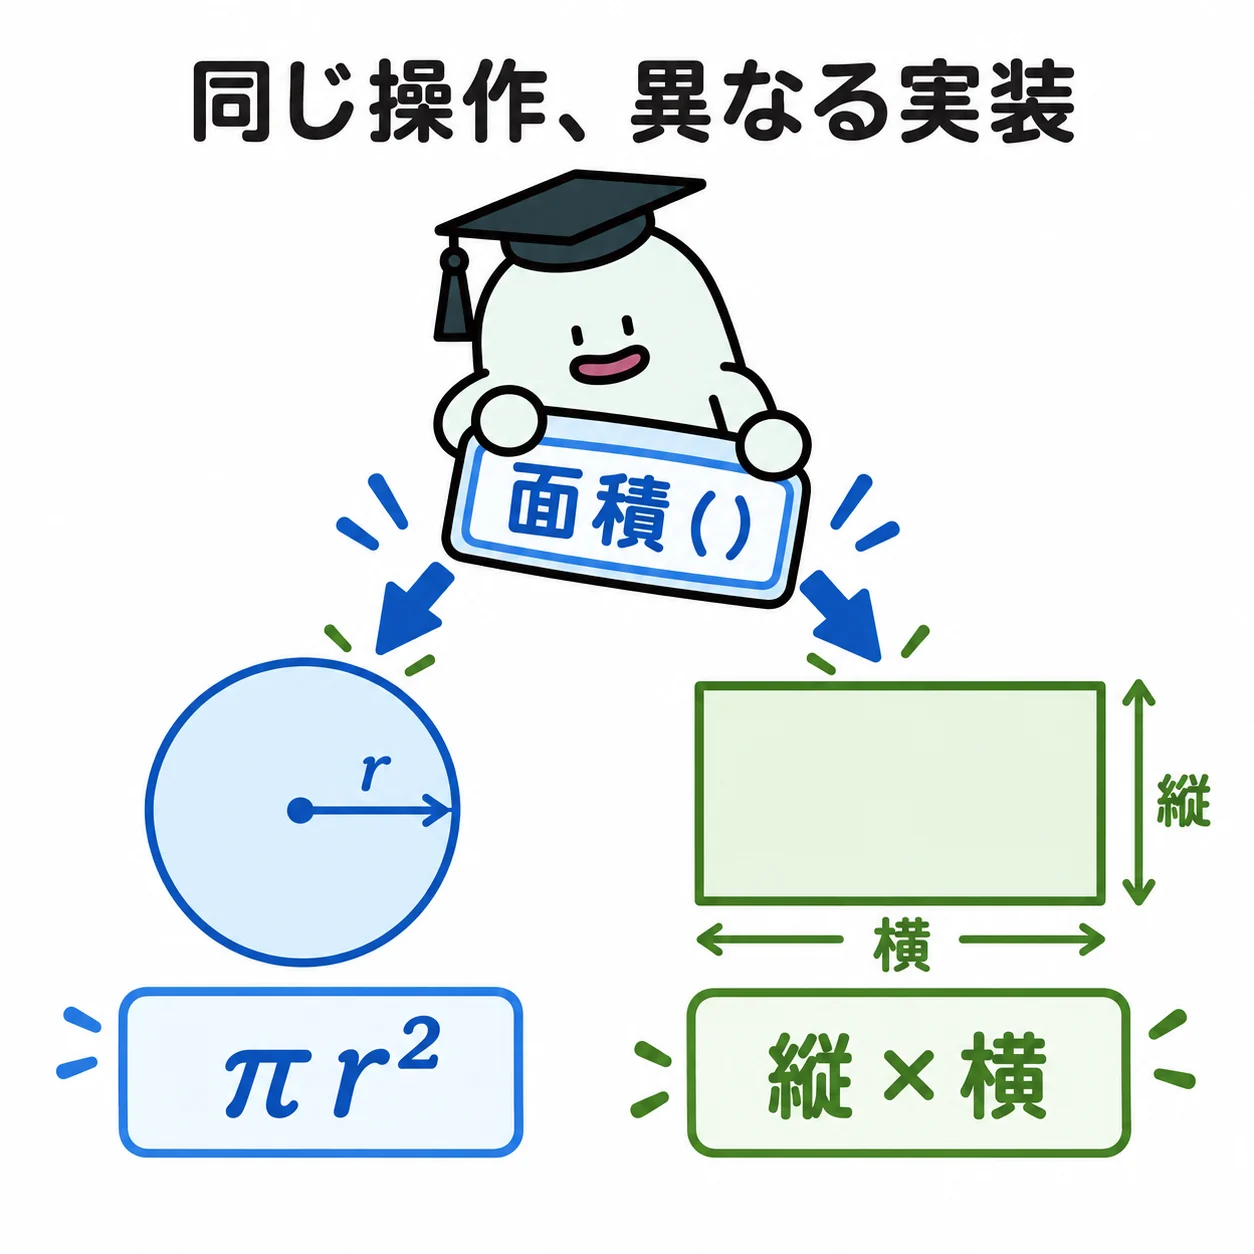
まず要点:多相性(ポリモーフィズム)とは、同じ操作方法で異なるクラスを扱っても、それぞれのクラスに合った動きになることです。呼び出す側のコードを変えずに新しい動きを追加できます。
解き方
- 同じ操作に対してクラスごとに違う動きをする性質の定義を確認する。
- オブジェクト指向の用語(継承、委譲、多相性など)の中から合うものを探す。
- 選択肢 ア不正解
- 委譲は、自分が受けた処理を別のオブジェクトに任せて実行してもらう設計の方法です。
- 選択肢 イ不正解
- 継承は、既存のクラスの属性やメソッドを引き継いで新しいクラスを作る仕組みです。
- 選択肢 ウ不正解
- コンポジションは、複数のクラスを部品として組み合わせて新しいクラスを作る方法です。
- 選択肢 エ正解
- 同じ操作に対してクラスごとに違う動きを実現する性質は多相性(ポリモーフィズム)です。
関連する分野を学ぶ
覚えるポイント
- ポリモーフィズム(多相性・多様性)=同一メッセージで異なる振る舞い
- 共通のインターフェースや基底クラスを利用して実現する
間違えやすいところ
- 多相性を実現する手段の一つである「継承」と、多相性そのものを混同しないこと
出題の前提:公開問題の出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.7 ↗(www.ipa.go.jp)
スクラムにおけるプロダクトオーナーの役割
プロジェクトマネジメント · アジャイル開発 / スクラム / プロダクトオーナー
アジャイル開発手法の一つであるスクラムにおいて,プロダクトバックログアイテムの内容や並び順を決定する役割をもつのは誰か。
解答・解説を表示
解答
エ
解説
まず要点:スクラムでプロダクトバックログの中身や並び順を決めるのはプロダクトオーナーです。スクラムチームはプロダクトオーナー、スクラムマスター、開発者の3つの役割で構成されます。
解き方
- スクラムチームの3つの役割であるPO、SM、開発者の仕事を整理する。
- プロダクトバックログを管理し順番を決める責任者がプロダクトオーナーだと確認する。
- 選択肢 ア不正解
- 開発者はスプリントで実際に成果物を作る役割で、バックログの順番を決める権限はありません。
- 選択肢 イ不正解
- 顧客は要望を出す立場ですが、スクラムチームの中でバックログの順番を決める役割ではありません。
- 選択肢 ウ不正解
- スクラムマスターはスクラムの進め方を支え、チームの邪魔を取り除く役割です。
- 選択肢 エ正解
- プロダクトバックログの中身や価値に基づく並び順を決めるのはプロダクトオーナーの仕事です。
関連する分野を学ぶ
覚えるポイント
- プロダクトオーナー(PO)=プロダクトの価値最大化・バックログの順序決定
- スクラムマスター(SM)=プロセスのファシリテーション・障害排除
- 開発者=バックログアイテムの実装とインクリメント作成
間違えやすいところ
- 要件を決めるのは顧客やスクラムマスターではなくプロダクトオーナーである点に注意する
出題の前提:Scrum Guideおよび公開問題の出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.7 ↗(www.ipa.go.jp)
アローダイアグラムによるクリティカルパスと最短所要日数
プロジェクトマネジメント · アローダイアグラム / クリティカルパス / 最早結合点時刻
図は,あるプロジェクトの作業 A ~ I とその作業日数を表している。このプロジェクトの最短所要日数は何日か。 〔作業構成〕 ・開始から作業A(3日) ・作業A終了後、作業B(6日)、作業E(5日)、作業F(14日)へ分岐 ・作業E終了後、ダミー作業を経て作業B終了ノードへ合流 ・作業B終了ノードから作業C(8日)、作業G(11日)、作業H(15日)へ分岐 ・作業G終了後、ダミー作業を経て作業C終了ノード(作業F合流ノード)へ合流 ・作業F、作業C、ダミー(作業Gから)が合流したノードから作業D(6日)へ ・作業Dと作業Hが合流したノードから作業I(5日)へ ・作業I終了でプロジェクト完了
解答・解説を表示
解答
エ
解説
まず要点:プロジェクトの最短所要日数は、開始から終了までの経路のうち、日数の合計が最も長い経路(クリティカルパス)の長さと同じです。全体はこの最も長い経路に合わせて決まります。
解き方
- 各ノードへの最早結合点時刻(先行作業が全て完了する最短時刻)を順に計算する。
- A終了時: 3日。B終了ノードは max(3+6, 3+5+0) = 9日。
- 作業D開始ノード(F・C・Gダミー合流)は max(3+14, 9+8, 9+11+0) = max(17, 17, 20) = 20日。
- 作業I開始ノードは max(20+6, 9+15) = max(26, 24) = 26日。
- 終了ノードは 26+5 = 31日となり、最短所要日数は31日と求まる。
- 選択肢 ア不正解
- A(3)+F(14)+D(6)+I(5)=28日など、これより長い経路があるので27日は誤りです。
- 選択肢 イ不正解
- A(3)+F(14)+D(6)+I(5)=28日ですが、Gを通る経路の方が長いので誤りです。
- 選択肢 ウ不正解
- A(3)+B(6)+H(15)+I(5)=29日ですが、Dを通る最長の経路より短いので誤りです。
- 選択肢 エ正解
- A(3)+B(6)+G(11)+ダミー(0)+D(6)+I(5)=31日が最も長く、最短所要日数は31日です。
関連する分野を学ぶ
覚えるポイント
- 「最短所要日数」は最長経路(クリティカルパス)の日数である
- 合流ノードでは最大値(max)を採用して最早結合点時刻を求める
間違えやすいところ
- ダミー作業の所要日数0と矢印の向きを見落として計算経路を誤る
出題の前提:公開問題の出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.8 ↗(www.ipa.go.jp)
情報セキュリティ監査における物理的安全対策の指摘事項
セキュリティ · 情報セキュリティ管理基準 / 物理的セキュリティ / 情報セキュリティ監査
サーバ室の物理的な安全対策の状況について,情報セキュリティ管理基準(平成28年)に照らして,情報セキュリティ監査を行って判明した状況のうち,監査人が,指摘事項として監査報告書に記載すべきものはどれか。
解答・解説を表示
解答
ウ
解説
まず要点:情報セキュリティ管理基準では、重要なサーバ室は外部からの入口をしっかり施錠し、入退室を管理することが求められます。物理的な区切りを守ることが大切です。
解き方
- サーバ室の物理的な安全対策として、管理基準で求められる内容を考える。
- 社外から直接入れる扉を無施錠にしている状態は重大な弱点で、監査の指摘対象だと確認する。
- 選択肢 ア不正解
- 人がいない場所でも警報装置が作動するのは侵入を検知する対策として適切で、指摘にはなりません。
- 選択肢 イ不正解
- 非常口や誘導灯の設置は人命を守る防災上の対策として適切で、指摘にはなりません。
- 選択肢 ウ正解
- 社外につながるドアを常時施錠しないのは、物理的な防護をしていないので指摘すべき不備です。
- 選択肢 エ不正解
- サーバ室の場所を外部に見せないのは機密を守るための対策として適切で、指摘にはなりません。
覚えるポイント
- サーバ室などのセキュリティ区画への出入口は常時施錠と認証管理が必須
- 室外に重要区画の標識を出さないことは防犯上推奨される
間違えやすいところ
- 「室外に表示していない」ことを不備だと勘違いしないよう注意する
出題の前提:情報セキュリティ管理基準(平成28年改正版)
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.8 ↗(www.ipa.go.jp)
マーケットバスケット分析の特徴
ストラテジ · データマイニング / マーケットバスケット分析 / アソシエーション分析
データマイニングの手法の一つであって,POS などの蓄積データから“一緒に買われる商品”の組合せを発見する分析手法はどれか。
解答・解説を表示
解答
エ
解説
まず要点:マーケットバスケット分析は、1回の買い物で一緒に買われた商品の組み合わせを調べる手法です。POSデータなどを使い、おすすめの販売や商品の並べ方に役立てます。
解き方
- POSデータから「同時に買われる商品の組み合わせ」を調べる手法の名前を思い出す。
- 買い物かごの中の組み合わせを調べる「マーケットバスケット分析」を選ぶ。
- 選択肢 ア不正解
- 3C分析は顧客、自社、競合の3つから事業の状況を分析する考え方です。
- 選択肢 イ不正解
- ABC分析は売上などの割合で商品を重要度ごとにA・B・Cへ分ける手法です。
- 選択肢 ウ不正解
- コンジョイント分析は、価格や性能などのどの要素が買う決め手になるかを調べる手法です。
- 選択肢 エ正解
- POSデータなどから一緒に買われる商品の組み合わせを見つけるのがマーケットバスケット分析です。
関連する分野を学ぶ
覚えるポイント
- マーケットバスケット分析=併売商品の相関発見(有名な「おむつとビール」の例)
- 指標として支持度(Support)、信頼度(Confidence)、リフト値(Lift)を用いる
間違えやすいところ
- 重要度で分けるABC分析と、一緒に買われる傾向を調べるバスケット分析を混同しない
出題の前提:公開問題の出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.9 ↗(www.ipa.go.jp)
生成AI利用におけるオプトアウト設定の目的
ストラテジ系 · 生成AI / オプトアウト / 情報セキュリティ
インターネット上の生成AIサービスを利用する際に,オプトアウトを設定することが有効となるケースはどれか。
解答・解説を表示
解答
イ
解説
まず要点:オプトアウトとは、もともと許諾している状態から「やめてほしい」と意思表示して外れることです。生成AIサービスでは、入力した情報が既定(あらかじめ決められた設定)でモデルの学習に使われる場合があります。そのため、学習に使わせたくないときにオプトアウトを設定します。
解き方
- オプトアウトが「データの提供や利用を拒否・除外する仕組み」だと確認します。
- 入力情報がモデルの学習データにためられるのを防ぐ目的にあう選択肢を選びます。
- 選択肢 ア不正解
- 著作権を主張できるかどうかは法律や利用規約で決まり、オプトアウトで変わるものではありません。
- 選択肢 イ正解
- 入力した情報をAIモデルの学習に使わせないようにするために、オプトアウトを設定します。
- 選択肢 ウ不正解
- 他の利用者に知ってほしいなら、学習を拒むオプトアウトではなく、共有や公開の設定が必要です。
- 選択肢 エ不正解
- 回答の正確さを高めるには、よい指示文の工夫や外部知識の参照が必要で、オプトアウトとは関係ありません。
覚えるポイント
- オプトアウトは「参加拒否・学習利用拒否」、オプトインは「事前の明示的な同意・承諾」を意味します。
間違えやすいところ
- 出力結果の品質向上や著作権の取得と、オプトアウトを混同しないよう注意しましょう。
出題の前提:令和7年度 基本情報技術者試験 科目A 公開問題 出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.9 ↗(www.ipa.go.jp)
ロングテールビジネスの成立条件と施策
ストラテジ系 · ロングテール / EC / マーケティング戦略
物販事業において,ロングテールをビジネスとして成功させるために必要な施策はどれか。
解答・解説を表示
解答
エ
解説
まず要点:ロングテールとは、売れる数が少ないたくさんの商品の売上を全部足すと、少数のヒット商品の売上を上回るという考え方です。店の棚の広さにしばられないインターネット販売で、保管や配送の費用を抑えることによって成り立ちます。
解き方
- ロングテールの特徴である「多品種少量販売」と「ニッチ商品を集めて利益を出す」ことを押さえます。
- ニッチ商品を大量に扱いつつ利益を出すための「豊富な品ぞろえ」と「在庫・物流コストの抑制」に合う施策を選びます。
- 選択肢 ア不正解
- 有名ブランド店を集めるやり方は、よく売れる商品に頼る従来の考え方で、ロングテールではありません。
- 選択肢 イ不正解
- 生活必需品を広く浅くそろえる実店舗は、売れ筋を効率よく回すコンビニなどの方法で、ロングテール戦略ではありません。
- 選択肢 ウ不正解
- 実店舗で買った商品を近くに無料配送するのは地域向けの付加サービスで、ロングテールを成り立たせる施策ではありません。
- 選択肢 エ正解
- 販売回数の少ないニッチ商品を数多くそろえ、保管費や配送費を抑えることが、ロングテール成功の必須条件です。
関連する分野を学ぶ
覚えるポイント
- ロングテールは「ネット通販×多品種少量×低コスト物流」によって成立するビジネスモデルです。
間違えやすいところ
- 売れ筋上位20%に力を入れるパレートの法則と、下位80%のニッチをまとめるロングテールを混同しないようにしましょう。
出題の前提:令和7年度 基本情報技術者試験 科目A 公開問題 出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.9 ↗(www.ipa.go.jp)
損益分岐点分析による必要客数の計算
ストラテジ系 · 損益分岐点 / 限界利益 / 目標利益の計算
次の条件で喫茶店を開業する場合,月10万円の利益を出すために必要な「1客席当たり1日平均の客数」は何人か。 〔条件〕 ・客1人当たりの売上高:500円 ・客1人当たりの変動費:100円 ・固定費:300,000円/月 ・1か月の営業日数:20日 ・客席数:10席
解答・解説を表示
解答
エ
解説
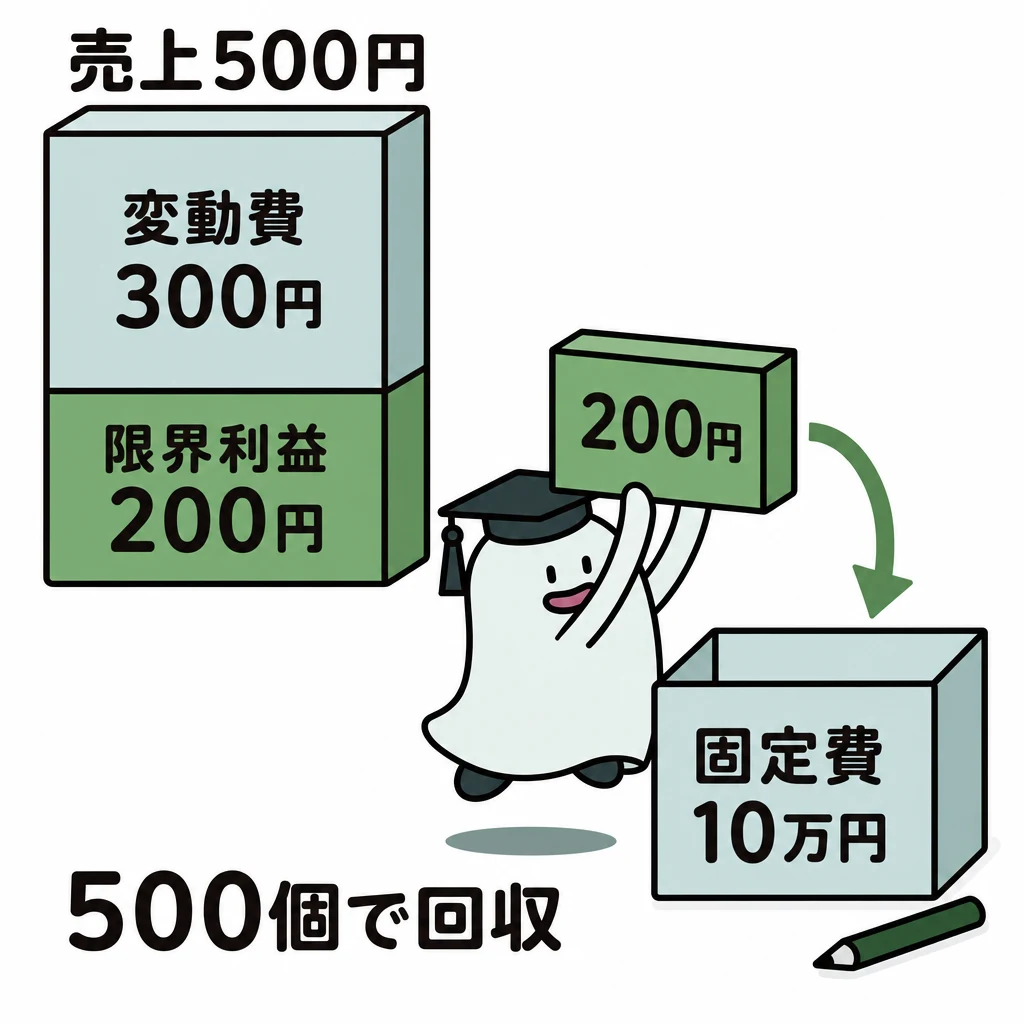
まず要点:目標の利益を出すのに必要な客数は、(固定費+目標利益)÷1人当たりの限界利益で求められます。利益は「売上高-変動費-固定費」で決まり、売上高から変動費を引いた残り(限界利益)が固定費と利益をまかなうもとになります。
解き方
- 1人当たりの限界利益(売上高500円-変動費100円=400円)を計算します。
- 固定費300,000円に目標利益100,000円を足した必要限界利益400,000円を求めます。
- 必要限界利益を1人当たり限界利益で割り、月の客数(400,000÷400=1,000人)を求めます。
- 月の客数を営業日数20日と客席数10席で割り、1席1日当たりの平均客数(1,000÷20÷10=5人)を出します。
- 選択肢 ア不正解
- 固定費30万円だけを回収する損益分岐点の客数(750人÷20日÷10席=3.75人)で、10万円の利益が入っていません。
- 選択肢 イ不正解
- 売上高500円をそのまま限界利益として計算するなどした誤った値です。
- 選択肢 ウ不正解
- 計算の順序や数値の取り違えによって出た誤った値です。
- 選択肢 エ正解
- 月に1,000人の来客が必要で、これを20日と10席で割ると1席1日平均5人になります。
関連する分野を学ぶ
覚えるポイント
- 目標利益達成に必要な限界利益 = 固定費 + 目標利益
- 1席1日あたりの客数 = 月間客数 ÷ 営業日数 ÷ 客席数
間違えやすいところ
- 目標利益を足し忘れて、損益分岐点(利益0円)の客数3.75人を選ばないよう注意しましょう。
出題の前提:令和7年度 基本情報技術者試験 科目A 公開問題 出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.10 ↗(www.ipa.go.jp)
カーボンフットプリント(CFP)の定義
ストラテジ系 · カーボンフットプリント / サステナビリティ / 環境経営
カーボンフットプリントの説明として,適切なものはどれか。
解答・解説を表示
解答
イ
解説
まず要点:カーボンフットプリントとは、製品が作られてから捨てられるまでの一生で出した温室効果ガスの量を、CO2の量に換算して商品やサービスに表示する仕組みです。名前の「足跡」のように、環境に残した負荷を分かりやすく見せ、消費者の低炭素な商品選びや企業の削減の取組を後押しします。
解き方
- カーボンフットプリントの考え方(一生全体、CO2換算、見える化・表示)を確認します。
- 各選択肢を照らし合わせ、製品の一生で出る温室効果ガスをCO2換算して表示するイを選びます。
- 選択肢 ア不正解
- 出した温室効果ガスから吸収・除去した分を引いて実質ゼロにする取組は「カーボンニュートラル」の説明です。
- 選択肢 イ正解
- 原料の調達から廃棄・リサイクルまでの一生で出る温室効果ガスをCO2換算して商品などに表示することを指します。
- 選択肢 ウ不正解
- 自動車などの大気汚染物質に関する決まりは、排出ガス規制(自動車排出ガス規制)の説明です。
- 選択肢 エ不正解
- 商品の生産から流通・販売までの経路をたどれるようにする仕組みは「トレーサビリティ」の説明です。
関連する分野を学ぶ
覚えるポイント
- カーボンフットプリント(CFP)は「ライフサイクル全体の温室効果ガス排出量をCO2換算して製品に表示・見える化」することです。
間違えやすいところ
- 実質ゼロを目指す「カーボンニュートラル」や、生産履歴を追う「トレーサビリティ」と用語を混同しないよう注意が必要です。
出題の前提:令和7年度 基本情報技術者試験 科目A 公開問題 出題基準
出典:IPA『2025年度 科目A 公開問題』
公式問題冊子 p.10 ↗(www.ipa.go.jp)
2025年度 科目A 公開問題
参照した公式資料
IPAが公開した2025年度 科目A 公開問題の問題・解答資料です。