

CPU・GPU・記憶装置とOSの働きから、構成、性能、稼働率、クラウドの責任分担まで整理します。装置を増やす効果と計算の前提を分けて考えます。
仕組みを理解する
ハードウェア
ハードウェアとは、CPUや記憶装置、センサなどの物理的な装置で、部品間のデータの流れで性能を考えます。
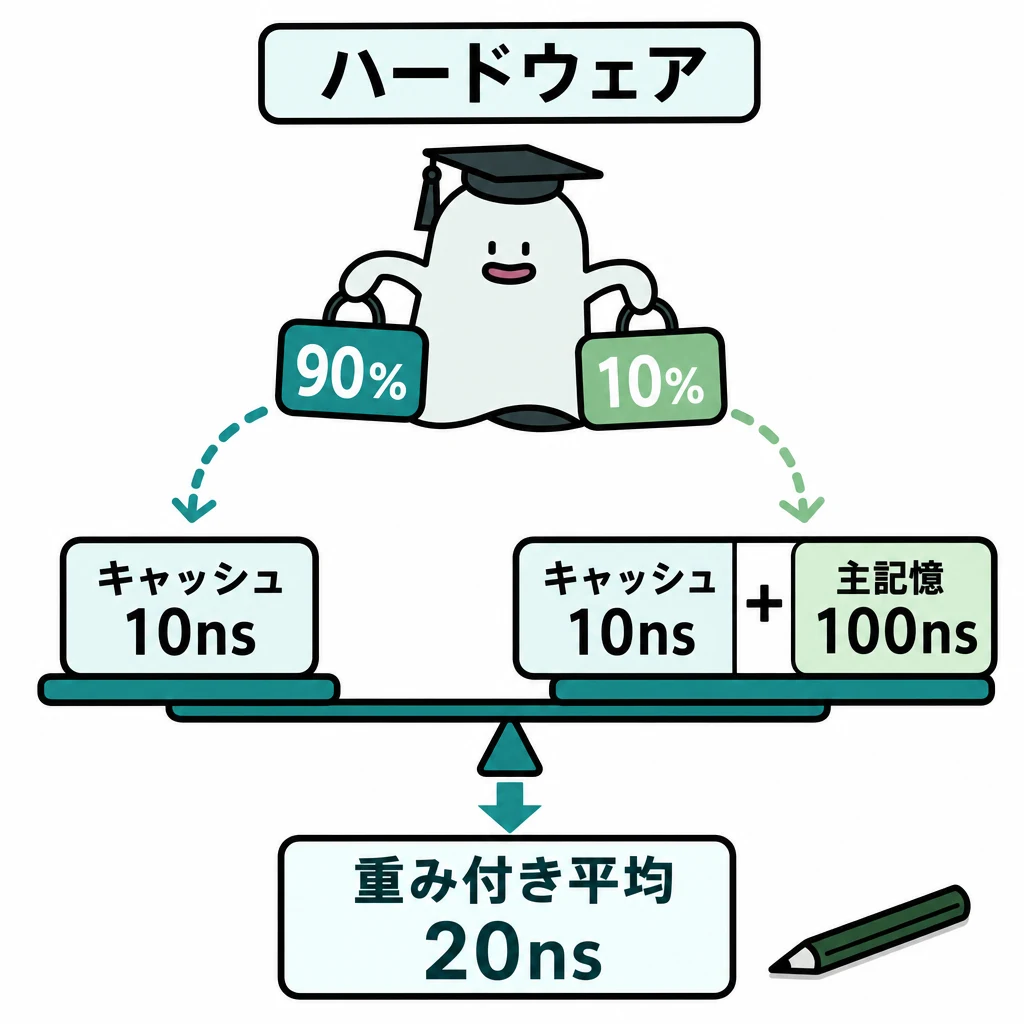
CPUが速くても、必要なデータを待つ時間が長いと処理は進みません。ハードウェアは部品の性能だけでなく、部品間のデータの流れで考えます。
基本の仕組み
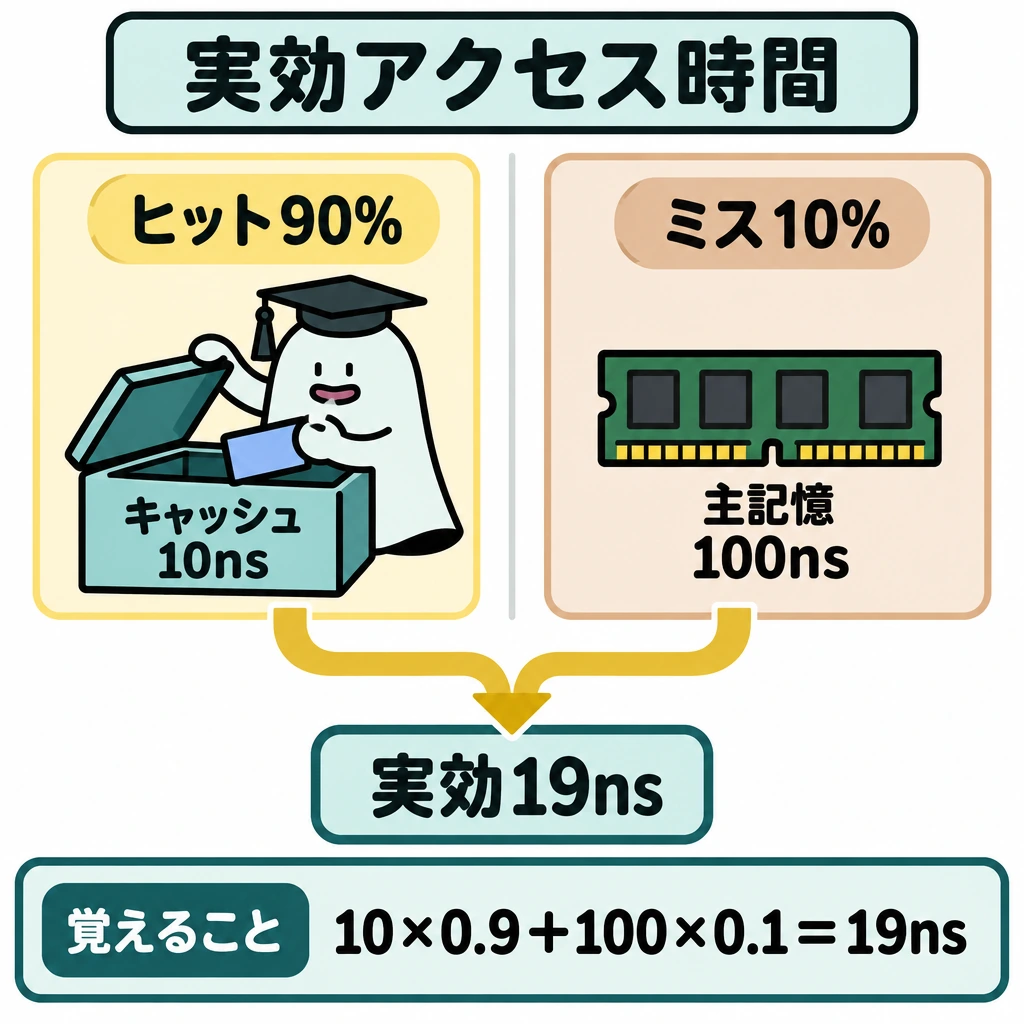
主記憶へのアクセスが100ns、キャッシュが10ns、ヒット率90%なら、実効アクセス時間は10×0.9+100×(1−0.9)=19nsです。基本情報技術者試験では「キャッシュ時間×ヒット率+主記憶時間×(1−ヒット率)」で求めるのが基本です。
キャッシュはよく使うデータを高速な記憶装置へ置きます。命令実行は命令の取出し・解読・実行などの段階に分けられ、パイプラインは複数命令の段階を少しずつずらして重ねます。
ミス時の時間にキャッシュ時間を含めるかは設問の定義で違います。「ミス時はキャッシュを確認してから主記憶を読む」と明記されていれば、ミス時を110nsとして0.9×10+0.1×110=20nsです。与えられた時間の意味を確認してから重み付き平均を計算します。
GPUは多数の演算を並列に行う構成を生かし、画像処理や行列計算などに使われます。CPUは制御や分岐を含む幅広い処理を担当し、GPUが全てのプログラムを必ず速くするわけではありません。センサは温度等の物理量を信号に変え、アクチュエータはモータ等で物理的な動作を起こします。
装置間の役割
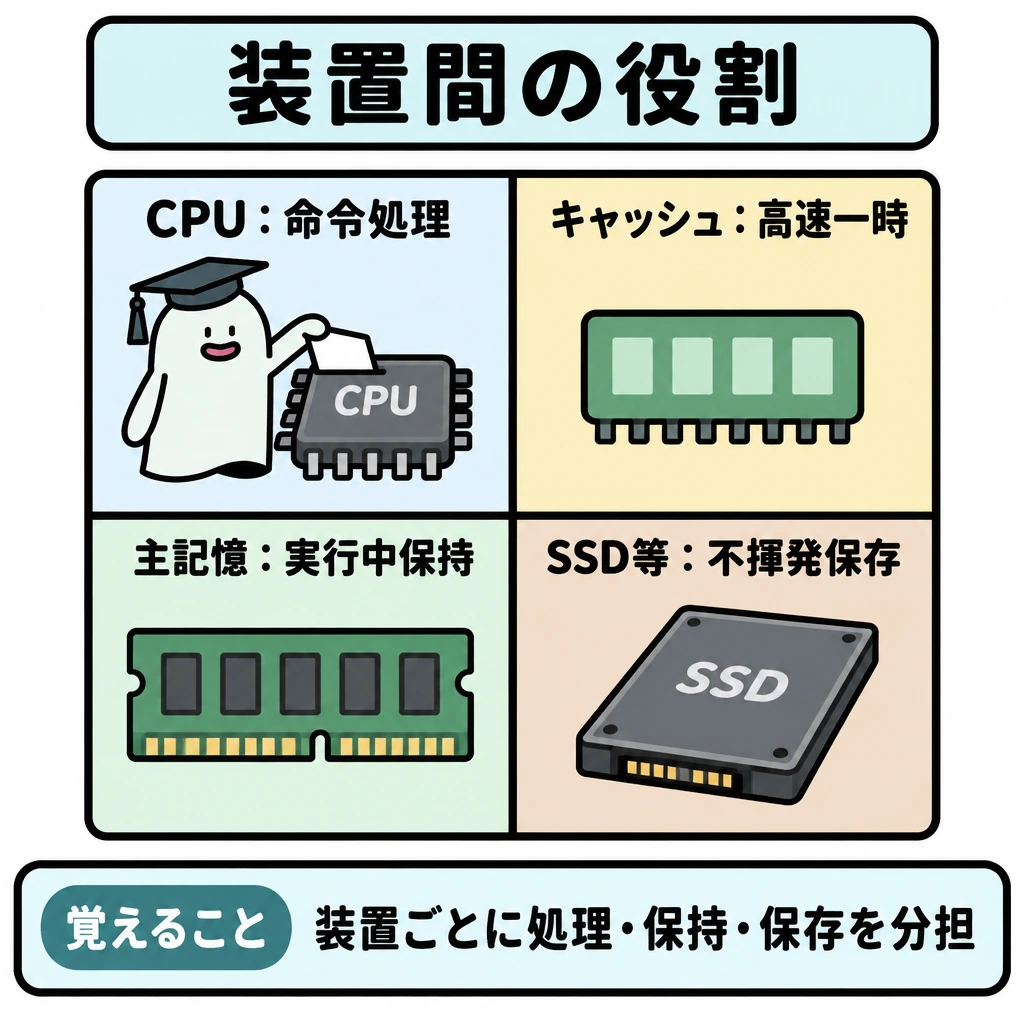
CPUは命令実行、主記憶は実行中の保持、キャッシュは速度差の吸収、補助記憶は不揮発の保存を担います。クロック周波数だけでは処理能力は決まらず、コア数・命令当たりの処理・メモリ待ちも影響します。
| 装置 | 主な役割 |
|---|---|
| CPU | 命令処理 |
| キャッシュ | 高速な一時保持 |
| 主記憶 | 実行中の保持 |
| SSD等 | 不揮発の保存 |
試験に出る
- 実効アクセス時間=キャッシュ時間×ヒット率+主記憶時間×(1−ヒット率)の計算と、ヒット率を逆算する問題。
- ミス時の時間にキャッシュ時間を含めるかは設問の定義で確認すること。
- 命令実行の段階とパイプラインの考え方。
- CPUは幅広い処理、GPUは並列計算が得意という役割の違い。
- センサは物理量を信号へ、アクチュエータは信号を動作へ変える点。
重要な言葉
- キャッシュ
- よく使うデータを置く高速な記憶装置。
- ヒット率
- キャッシュに目的のデータがある割合。
- パイプライン
- 複数命令の段階を重ねて処理する方式。
- アクチュエータ
- 信号を受けて物理的な動作を起こす装置。
確認問題
確かめようヒット率が上がると、この例の平均アクセス時間は?
短くなり、10nsへ近づきます。
キャッシュのヒット率が上がると、平均アクセス時間は短くなる。
GPUは、どんなプログラムでもCPUより速く実行できる。
主記憶100ns、キャッシュ10ns、ヒット率90%の平均アクセス時間は?
画像処理や行列計算など並列計算が得意な装置は?
が速くても、必要なデータを待つ時間が長いと処理は進みません。は部品の性能だけでなく、部品間のデータの流れで考えます。
主記憶へのアクセスが100ns、が10ns、ヒット率90%なら、実効アクセス時間は10×0.9+100×(1−0.9)=です。基本情報技術者試験では「キャッシュ時間×ヒット率+主記憶時間×(1−ヒット率)」で求めるのが基本です。
キャッシュはよく使うデータを高速な記憶装置へ置きます。は命令の取出し・解読・実行などの段階に分けられ、は複数命令の段階を少しずつずらして重ねます。
ミス時の時間にを含めるかは設問の定義で違います。「ミス時はキャッシュを確認してから主記憶を読む」と明記されていれば、ミス時を110nsとして0.9×10+0.1×110=20nsです。与えられた時間の意味を確認してからを計算します。
は多数の演算を並列に行う構成を生かし、画像処理や行列計算などに使われます。CPUは制御や分岐を含む幅広い処理を担当し、GPUが全てのプログラムを必ず速くするわけではありません。センサは温度等の物理量を信号に変え、はモータ等で物理的な動作を起こします。
オペレーティングシステム
オペレーティングシステムとは、CPU時間やメモリ、装置を管理して複数のプログラムを動かす基本ソフトです。
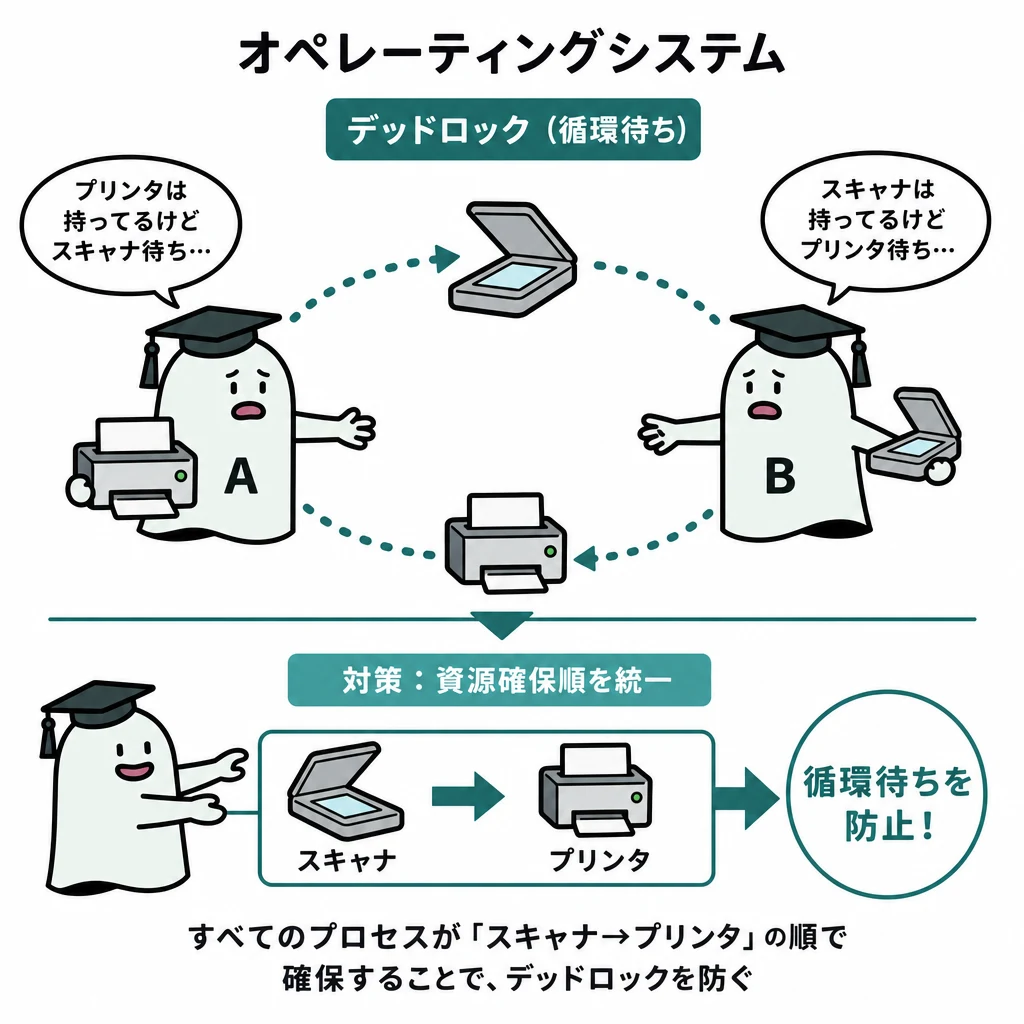
複数のアプリが同時に動くように見えるのは、OSがCPU時間やメモリを配分しているためです。各プログラムが装置を独占しないよう管理します。
基本の仕組み
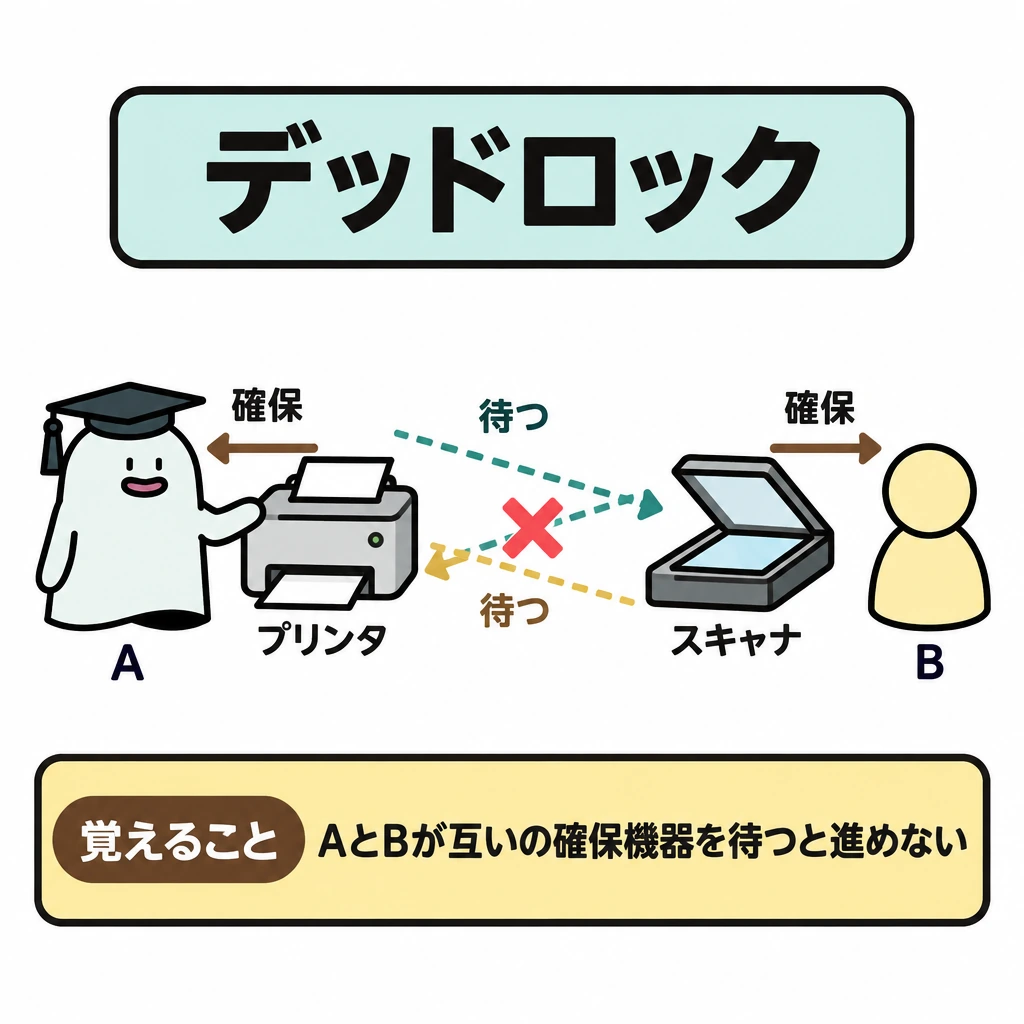
Aがプリンタを確保してスキャナを待ち、Bがスキャナを確保してプリンタを待つと、互いに進めなくなります。これがデッドロックの典型例です。
プロセスは実行中のプログラムの単位です。仮想記憶は主記憶と補助記憶を利用してアドレス空間を管理し、必要なページを主記憶へ読み込みます。
ページの入替えが多すぎるスラッシングでは、CPUの計算より入替えに時間が取られます。仮想記憶を増やすだけで必ず高速化するわけではありません。
OSの資源管理
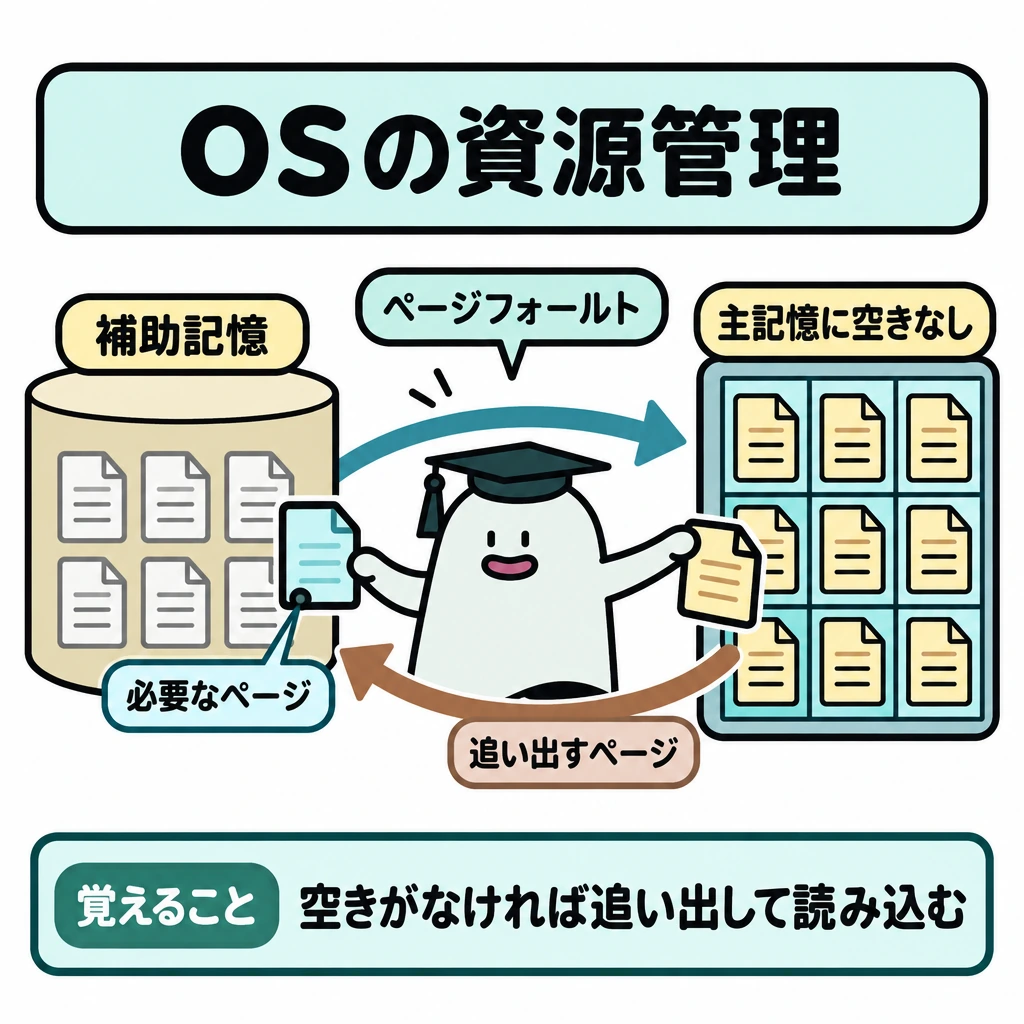
OSはプロセス・スレッド、主記憶、ファイル、入出力を管理します。仮想記憶は補助記憶を使って主記憶より広いアドレス空間を提供し、必要なページが主記憶にないとき(ページフォールト)に読み込みます。排他制御は共有資源の同時更新を防ぎます。
CPUを割り当てる順序(スケジューリング)には、到着順、処理時間の短い順、優先度順、一定時間(タイムクウォンタム)ごとに順番に切り替えるラウンドロビンなどがあります。
主記憶に空きがないままページを読み込むときは、追い出すページを選びます。FIFOは最も早く読み込んだページ、LRUは最後に参照されてから最も長く使われていないページを追い出します。
| 管理対象 | 代表的な仕組み |
|---|---|
| CPU | スケジューリング |
| 主記憶 | 仮想記憶・ページング |
| 共有資源 | 排他制御 |
| ページ置換方式 | 追い出すページ |
|---|---|
| FIFO | 最も早く主記憶へ読み込んだページ |
| LRU | 最後の参照から最も長い時間がたったページ |
| LFU | 参照回数が最も少ないページ |
試験に出る
- OSがCPU時間やメモリを配分し、装置の独占を防ぐこと。
- 互いに相手の装置を待つデッドロックの典型例。
- プロセスと仮想記憶の役割(必要なページを主記憶へ読み込む)。
- スラッシングでは入替えに時間を取られること。
- 装置を同じ順序で確保すると循環待ちを減らせること。
- ページ置換方式(FIFO・LRU)で追い出すページを順に追う問題と、ラウンドロビンなどのスケジューリング。
重要な言葉
- プロセス
- 実行中のプログラムの単位。
- 仮想記憶
- 主記憶と補助記憶を組み合わせてアドレス空間を管理する仕組み。
- デッドロック
- 互いに相手の資源を待ち、どちらも進めなくなる状態。
- スラッシング
- ページ入替えが頻発して処理効率が落ちる現象。
確認問題
確かめよう両プログラムが同じ順序で装置を確保すると何を減らせる?
循環待ちによるデッドロックのおそれです。
デッドロックは、複数の処理が互いに相手の資源を待つことで起こる。
スラッシングは、装置を待って進めなくなる状態である。
互いに相手の装置を待って進めなくなる状態は?
実行中のプログラムの単位を何という?
複数のアプリが同時に動くように見えるのは、がCPU時間やを配分しているためです。各プログラムが装置を独占しないよう管理します。
Aがプリンタを確保してスキャナを待ち、Bがスキャナを確保してプリンタを待つと、互いに進めなくなります。これがのです。
は実行中のプログラムの単位です。は主記憶と補助記憶を利用してアドレス空間を管理し、必要なページを主記憶へ読み込みます。
ページの入替えが多すぎるでは、CPUの計算より入替えに時間が取られます。仮想記憶を増やすだけで必ずするわけではありません。
システム構成
システム構成とは、装置の組合せや予備機の持ち方で、故障時の停止のしやすさや処理能力を決める設計です。
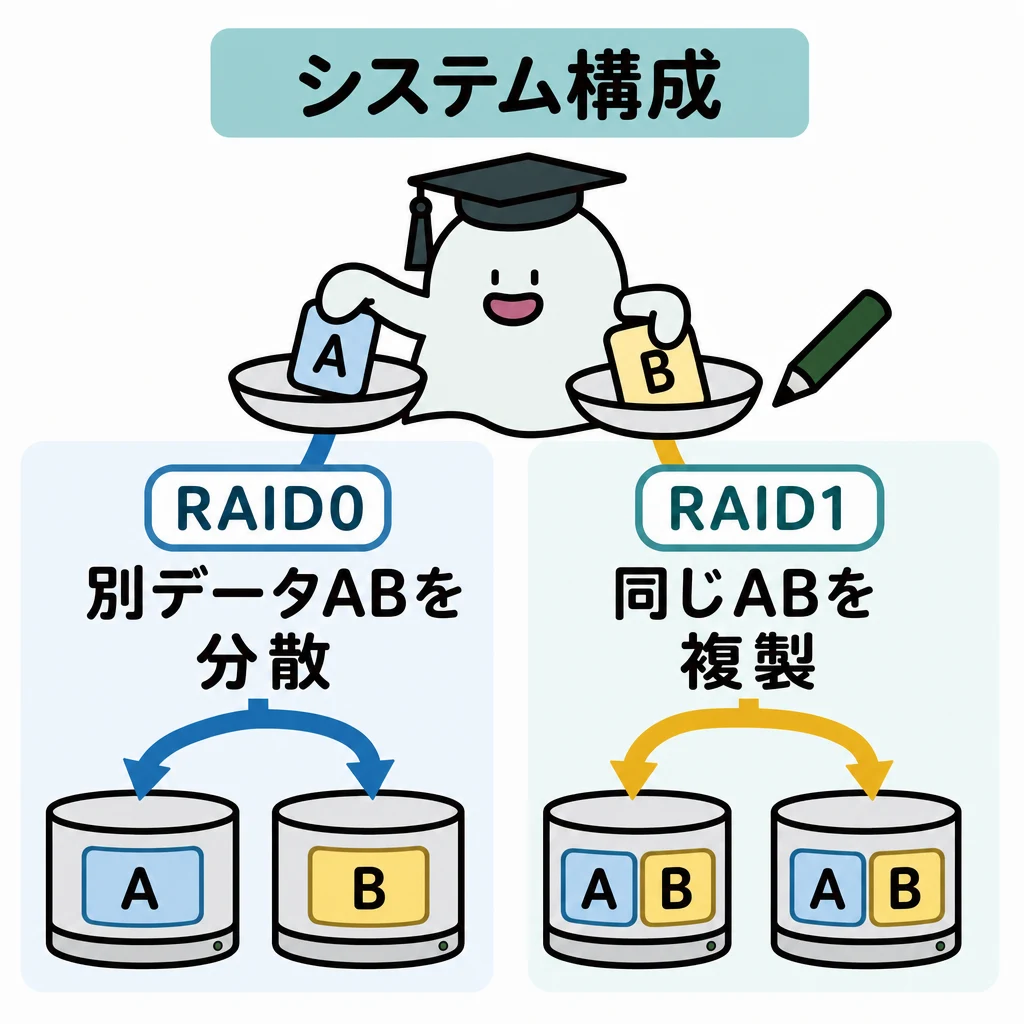
一台の故障でサービス全体が止まる構成と、予備機へ切り替えられる構成では、停止のしやすさが違います。
基本の仕組み
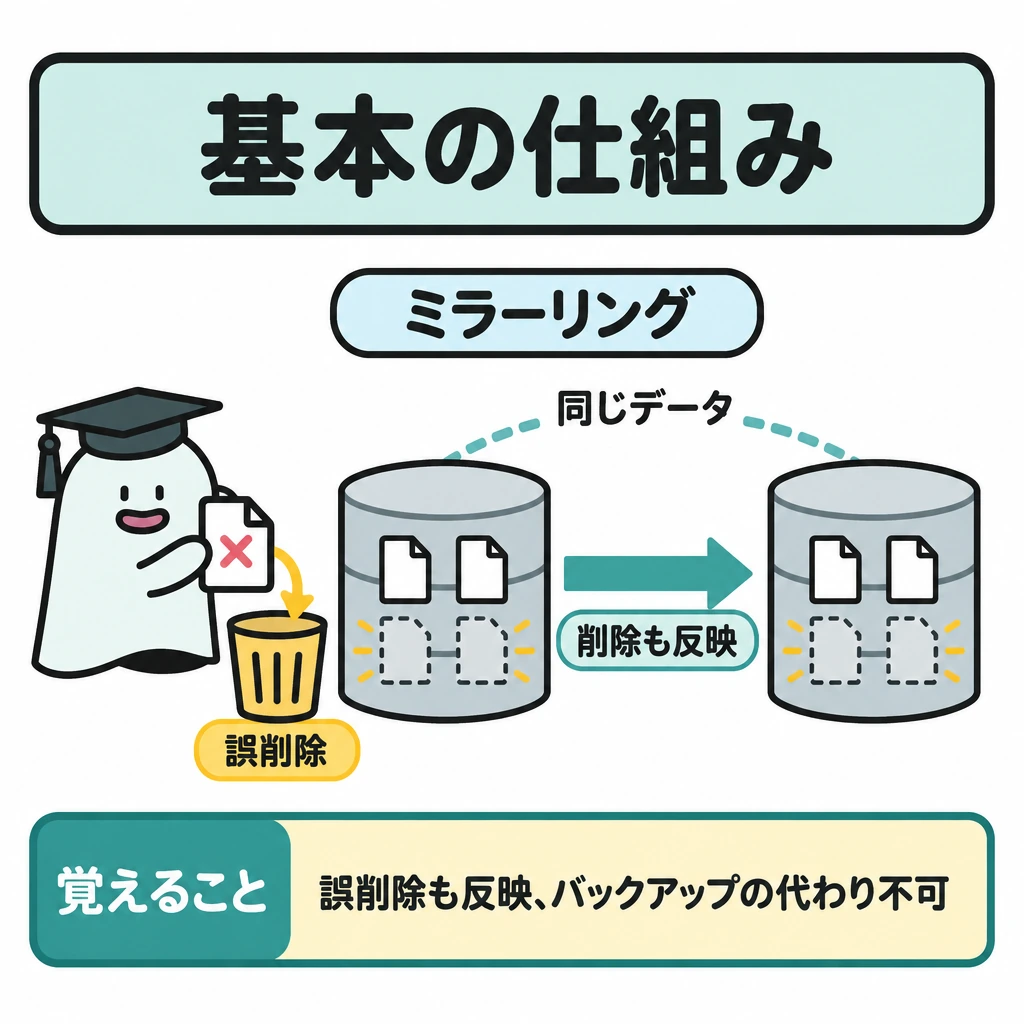
RAID1は同じデータを複数ディスクへ書くミラーリングです。一方、RAID0はデータを分散して性能向上を狙いますが、冗長性はありません。
負荷分散は要求を複数の処理装置へ割り振り、冗長化は故障しても機能を維持する設計です。両方を行う構成もありますが、目的を分けて理解します。
ミラーリングでは誤削除も反映されるため、バックアップの代わりにはなりません。共通電源など一つの故障点が残っていないかも確認します。
構成と故障への備え
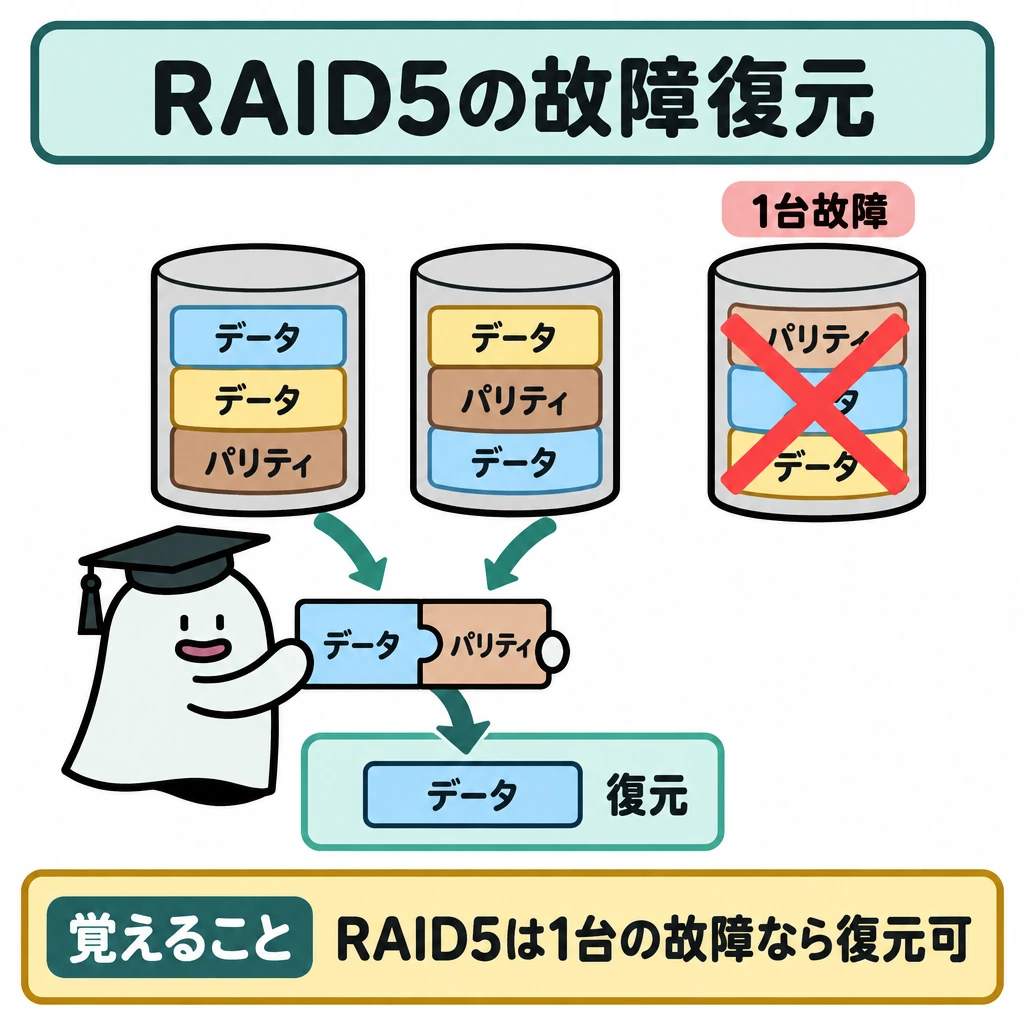
クライアントサーバ、三層構成、分散構成は役割の分担が異なります。負荷分散は処理を振り分け、冗長化は故障時の代替を用意します。
RAID0はデータを複数ディスクへ分散して書くストライピングで、冗長性はありません。RAID1は同じデータを複製します。RAID5はデータと誤り訂正用のパリティを複数ディスクへ分散して書き、1台の故障ならデータを復元できます。n台のRAID5で使える容量は(n−1)台分です。
デュアルシステムは2系統で同じ処理を行い、結果を照合します。デュプレックスシステムは主系で処理し、故障時に待機系へ切り替えます。待機系を起動したまま待たせるのがホットスタンバイ、停止した状態から起動するのがコールドスタンバイで、前者のほうが切替えが速くなります。
| 方式 | 主な狙い | 故障への強さ |
|---|---|---|
| RAID0 | 分散(ストライピング)による性能向上 | 1台の故障で全体のデータを失う |
| RAID1 | 複製(ミラーリング) | 1台が壊れても残りで継続 |
| RAID5 | データとパリティの分散 | 1台の故障まで復元可能 |
| 負荷分散 | 処理の分配 | 構成による |
| システム構成 | 特徴 |
|---|---|
| デュアルシステム | 2系統が同じ処理を行い結果を照合 |
| デュプレックスシステム | 主系が処理し、故障時に待機系へ切替え |
試験に出る
- RAID1はミラーリングで冗長、RAID0は分散で冗長性がないこと。RAID5はパリティで1台の故障まで復元でき、容量は(n−1)台分。
- デュアルシステム(2系統で照合)とデュプレックスシステム(主系と待機系)の違い。
- 負荷分散(処理の割振り)と冗長化(故障時の維持)は目的が違うこと。
- ミラーリングは誤削除も反映され、バックアップの代わりにならない点。
- 共通電源など単一の故障点が残っていないかを確認すること。
- 予備機へ切り替えられる構成かどうかで停止のしやすさが変わる点。
重要な言葉
- RAID
- 複数ディスクを組み合わせて性能や冗長性を高める構成。
- ミラーリング
- 同じデータを複数のディスクへ書く方式。
- 冗長化
- 故障しても機能を維持できるように予備を用意すること。
- 負荷分散
- 要求を複数の処理装置へ割り振ること。
確認問題
確かめようRAID0なら一台壊れても安全?
いいえ。冗長性がないため構成全体のデータを失うおそれがあります。
RAID0は冗長性があり、1台壊れてもデータを失わない。
ミラーリングは誤削除にも対応できるので、バックアップの代わりになる。
1台壊れてもデータを失わない冗長性を持つRAIDは?
要求を複数の処理装置へ割り振ることを何という?
一台の故障でサービス全体が止まる構成と、へ切り替えられる構成では、のしやすさが違います。
は同じデータを複数ディスクへ書くミラーリングです。一方、はデータを分散して性能向上を狙いますが、冗長性はありません。
は要求を複数の処理装置へ割り振り、は故障しても機能を維持する設計です。両方を行う構成もありますが、目的を分けて理解します。
では誤削除も反映されるため、バックアップの代わりにはなりません。共通電源など一つのが残っていないかも確認します。
性能評価
性能評価とは、応答時間やスループットなどの指標で、システムの速さや処理能力を測ることです。
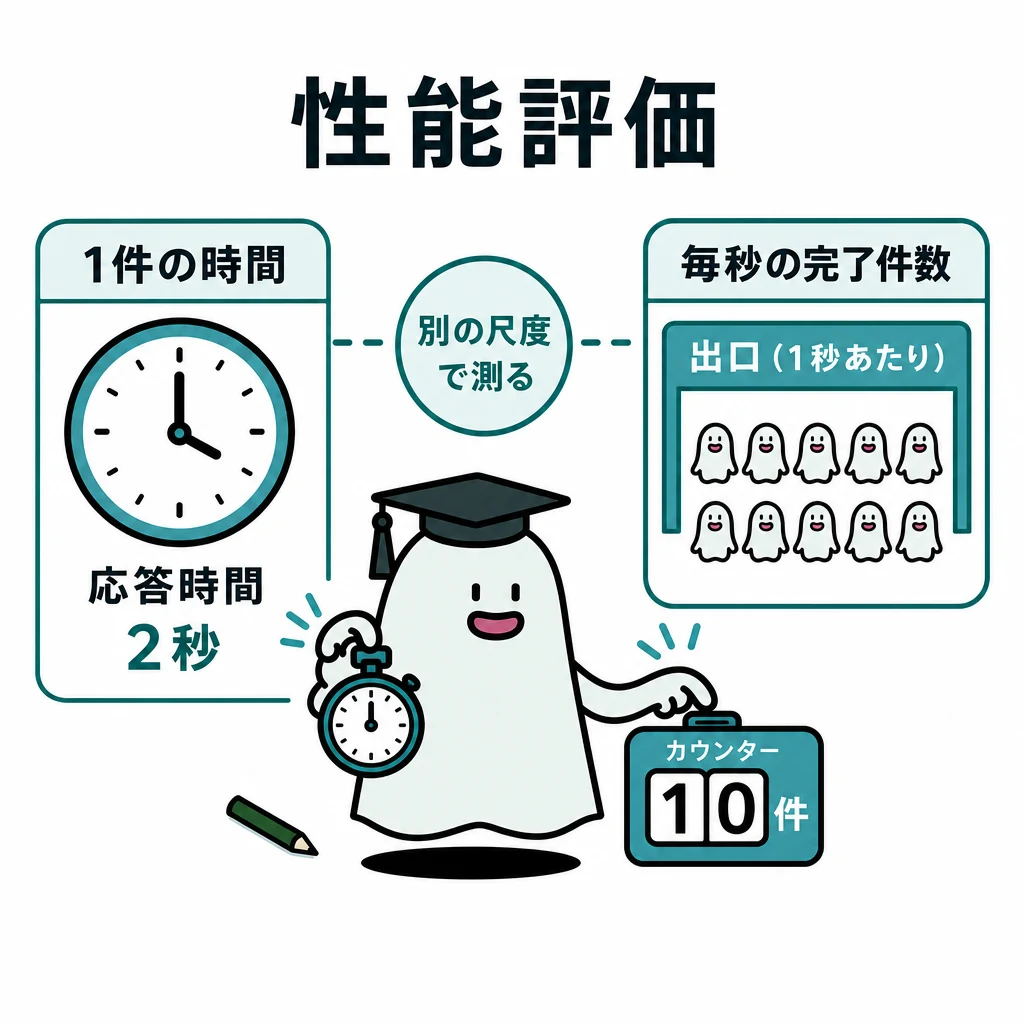
一人の待ち時間を短くすることと、一時間に多くの仕事を処理することは別の目標です。性能指標が何を測るかを先に決めます。
基本の仕組み
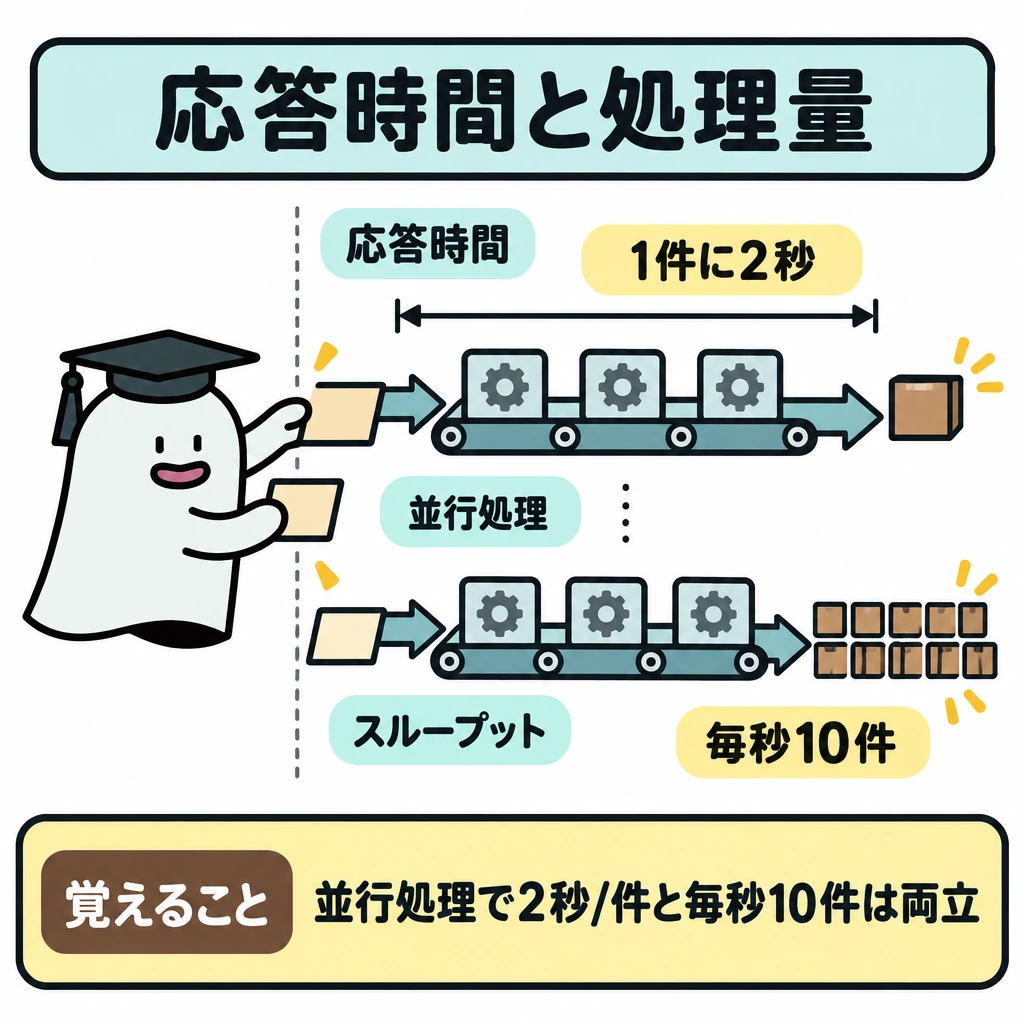
一件の応答が2秒でも、並行処理によって毎秒10件を完了できるシステムはあり得ます。応答時間は一件の所要時間、スループットは単位時間当たりの処理量です。
CPU時間は命令数×平均CPI÷クロック周波数で表せます。同じ命令数でも、命令当たりのクロック数や周波数で所要時間が変わります。
例えばクロック周波数2GHzで平均CPIが4なら、1命令の平均実行時間は4÷(2×10⁹)=2ナノ秒です。1秒間に5億命令を実行できるので、性能は500MIPSです。
クロック周波数だけで異なるCPUの実行速度を決められません。命令構成やCPI、メモリ待ちなど条件をそろえて比較します。
性能指標の使い分け
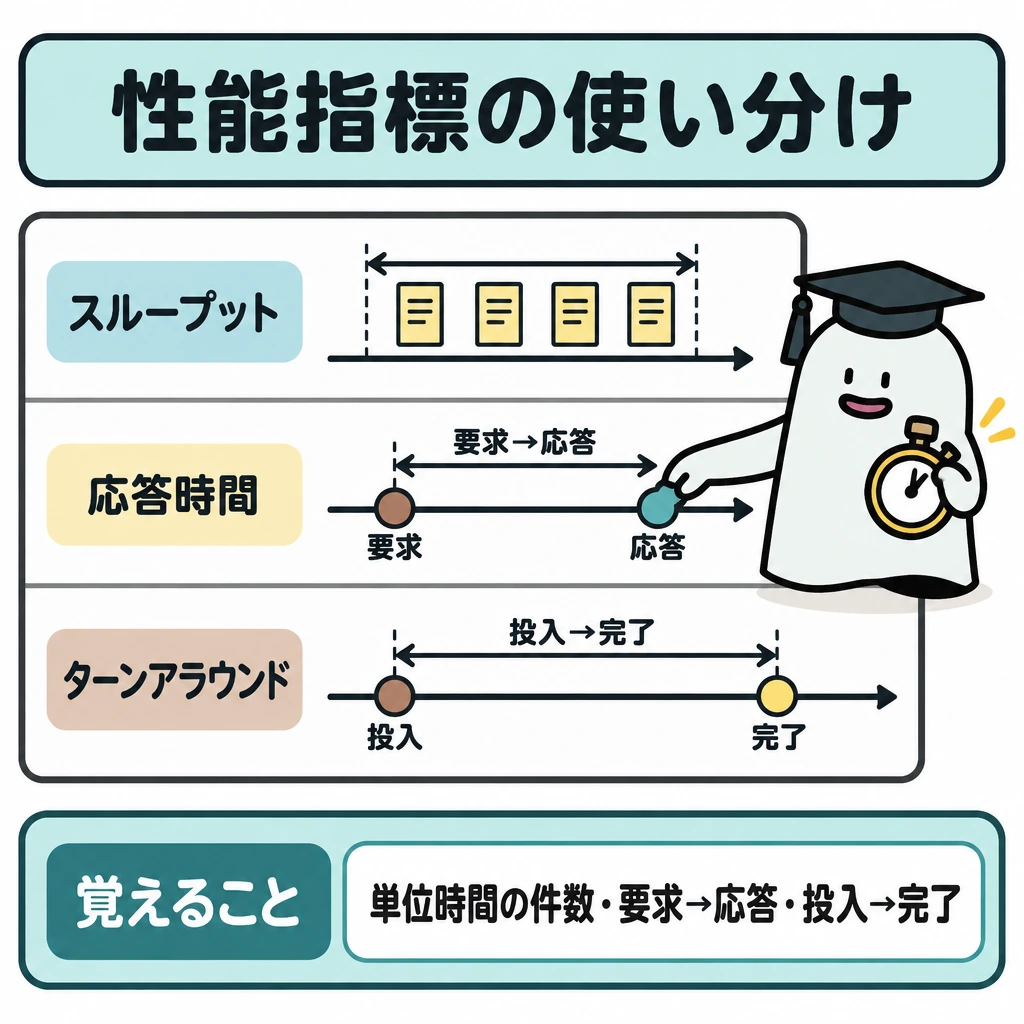
スループットは単位時間当たりの処理量、応答時間は要求から応答までの時間、ターンアラウンド時間は投入から処理完了までです。CPU使用率が高いだけでは原因を特定できず、待ち行列や入出力のボトルネックを調べます。
| 指標 | 測るもの |
|---|---|
| スループット | 単位時間の処理件数 |
| 応答時間 | 要求から応答まで |
| ターンアラウンド | 投入から完了まで |
試験に出る
- 応答時間(1件の所要時間)とスループット(単位時間の処理量)の違い。
- CPU時間=命令数×平均CPI÷クロック周波数の関係と、周波数・CPIからMIPS値を求める計算(2GHz・CPI4なら500MIPS)。
- 応答が遅くても並行処理でスループットを上げられる場合があること。
- クロック周波数だけで異なるCPUの速さは比べられないこと。
- 比較は命令構成やCPI、メモリ待ちなど条件をそろえて行うこと。
重要な言葉
- 応答時間
- 1件の処理に要する時間。
- スループット
- 単位時間当たりに処理できる量。
- CPI
- 1命令当たりに必要なクロック数の平均。
- MIPS
- 1秒当たりの命令実行回数を百万単位で表す指標。
確認問題
確かめよう命令数とCPIが同じで周波数が2倍ならCPU時間は?
理想化した条件で半分です。
応答時間が長くても、スループットが高いシステムはあり得る。
クロック周波数が高いCPUほど、必ず実行速度が速い。
1件の処理に要する時間を表す指標は?
CPU時間を表す式はどれ?
一人のを短くすることと、一時間に多くの仕事を処理することは別の目標です。が何を測るかを先に決めます。
一件の応答が2秒でも、並行処理によって毎秒10件を完了できるシステムはあり得ます。は一件の所要時間、は単位時間当たりの処理量です。
CPU時間は命令数×平均÷で表せます。同じ命令数でも、命令当たりのクロック数や周波数で所要時間が変わります。
クロック周波数だけで異なるCPUの実行速度を決められません。やCPI、メモリ待ちなどをそろえて比較します。
信頼性と稼働率
稼働率とは、装置が使える時間の割合で、MTBFとMTTRの関係から求めます。
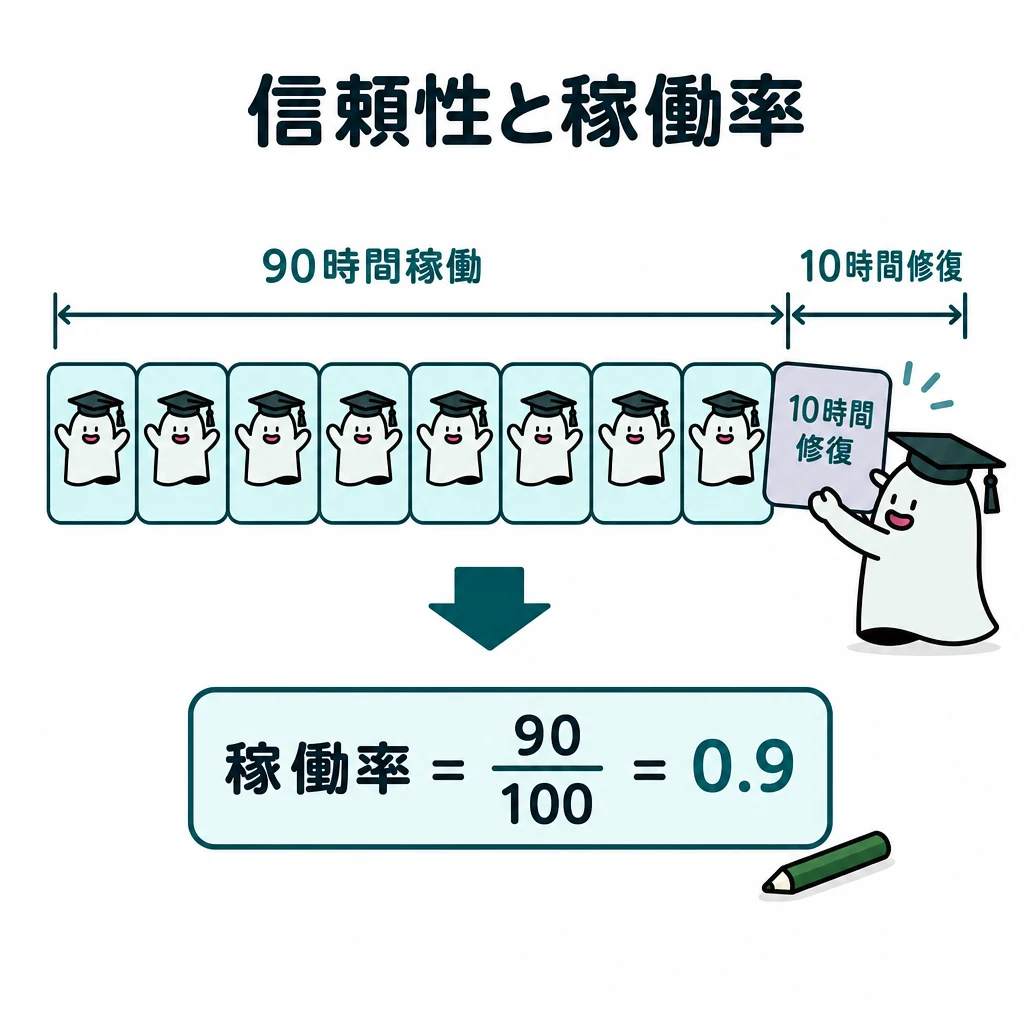
故障しにくい機械でも、修理に長時間かかると利用できる割合は下がります。信頼性と保守性の両方を見る必要があります。
基本の仕組み
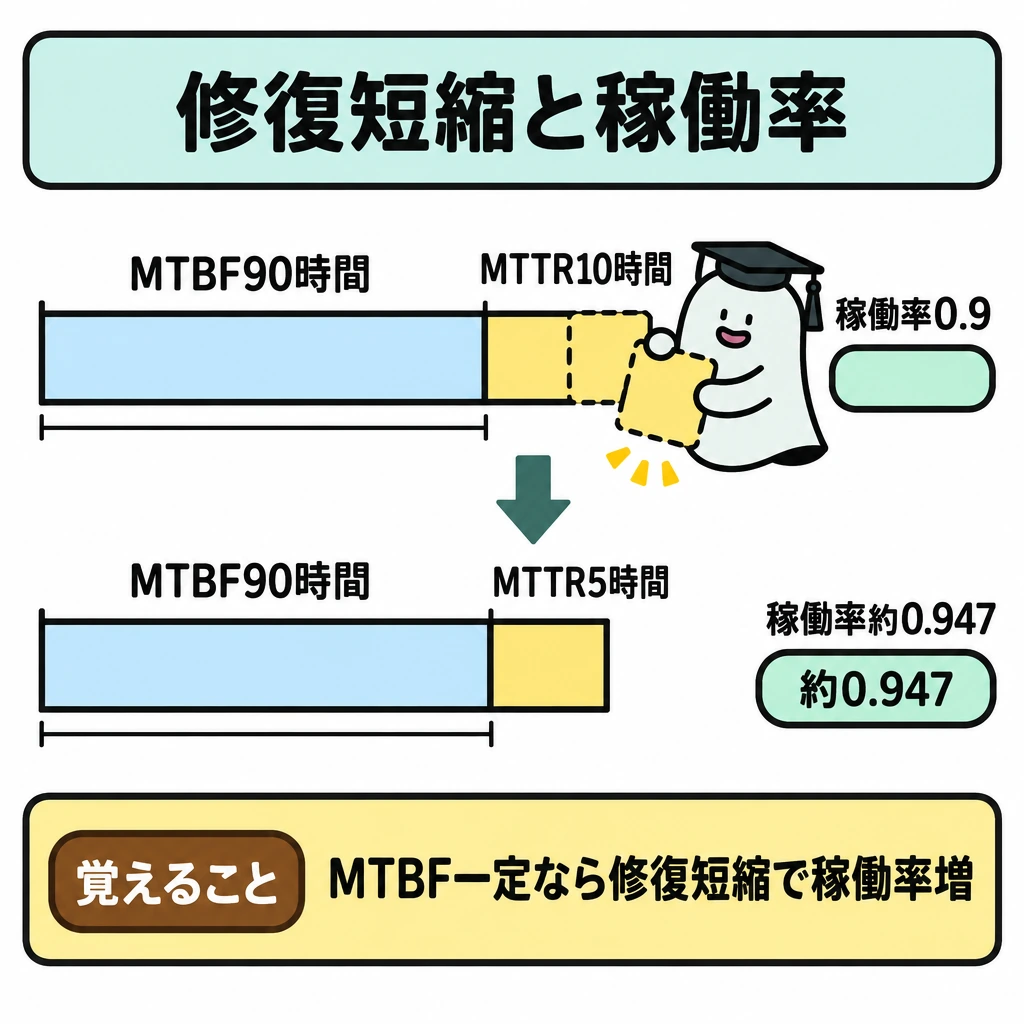
平均故障間隔MTBFが90時間、平均修復時間MTTRが10時間なら、稼働率は90÷(90+10)=0.9です。修復時間を5時間へ減らすと90÷95≒0.947に上がります。
稼働率はMTBF÷(MTBF+MTTR)で考えます。独立した装置を両方必要とする直列系では稼働率を掛け、どちらか一つでよい並列系では両方停止する確率を1から引きます。
並列系の式には故障が独立などの前提があります。共通電源の故障で両方止まる場合に、単純な独立計算をそのまま使えません。
稼働率の計算条件
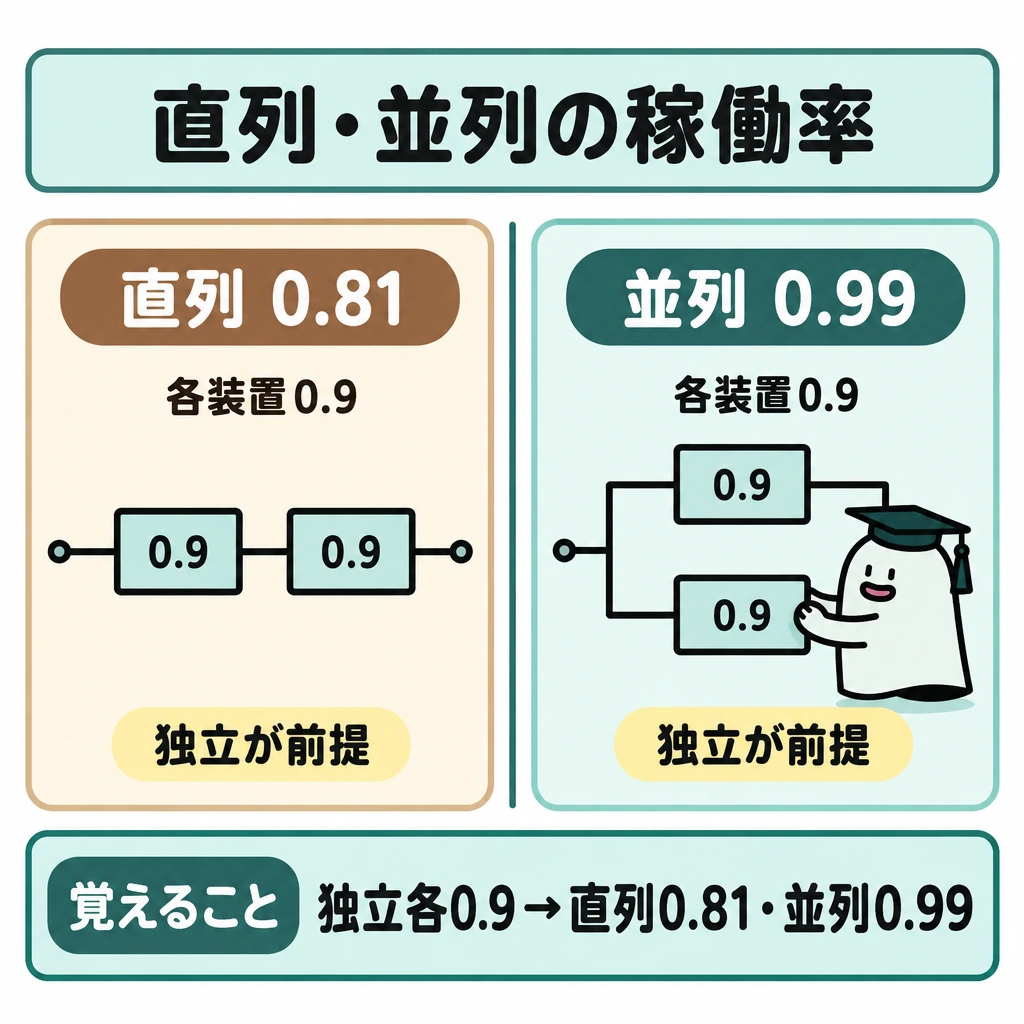
独立した装置を直列に置くと全てが稼働する確率を掛け、並列冗長では全て停止する確率を1から引きます。稼働率0.9の装置2台なら、直列は0.9×0.9=0.81、並列は1−(1−0.9)×(1−0.9)=0.99です。
直列と並列を組み合わせた構成は、内側のまとまりから一つの装置とみなして順に計算します。共通電源のように両系を同時に止める共通原因故障があれば、独立性の仮定は成り立ちません。
| 構成 | 稼働率 | 稼働率0.9の例 |
|---|---|---|
| 単一装置 | MTBF÷(MTBF+MTTR) | 0.9 |
| 直列2台 | A×B | 0.81 |
| 並列2台 | 1−(1−A)(1−B) | 0.99 |
試験に出る
- 稼働率=MTBF÷(MTBF+MTTR)の計算。
- 直列系は稼働率を掛け、並列系は両方停止する確率を1から引くこと。
- MTTRを短くすると稼働率が上がる点。
- 並列系の式は故障が独立という前提の上で成り立つこと。
- 共通電源の故障では独立計算がそのまま使えないこと。
重要な言葉
- MTBF
- 平均故障間隔。修理後に稼働を再開してから次に故障するまでの平均稼働時間。
- MTTR
- 故障から復旧までの平均修復時間。
- 稼働率
- 使える時間の割合。MTBF÷(MTBF+MTTR)で求める。
- 直列系
- 両方の装置が動いている必要がある構成。
確認問題
確かめよう稼働率0.9の独立した装置が直列なら?
0.81。両方が稼働している必要があるからです。
MTTRを短くすると、稼働率は上がる。
並列系の稼働率は、故障が独立という前提がなくても同じ式で求まる。
MTBF90時間、MTTR10時間の稼働率は?
独立した装置を両方必要とする直列系の稼働率は?
故障しにくい機械でも、修理に長時間かかると利用できる割合は下がります。との両方を見る必要があります。
平均故障間隔が90時間、平均修復時間が10時間なら、稼働率は90÷(90+10)=0.9です。修復時間を5時間へ減らすと90÷95≒0.947に上がります。
稼働率はMTBF÷(MTBF+MTTR)で考えます。独立した装置を両方必要とするでは稼働率を掛け、どちらか一つでよいでは両方停止する確率を1から引きます。
並列系の式には故障が独立などの前提があります。の故障で両方止まる場合に、単純なをそのまま使えません。
クラウド・仮想化と責任分担
クラウドとは、ネットワーク経由で計算資源やアプリを利用する仕組みで、提供者と利用者の管理範囲を分けます。
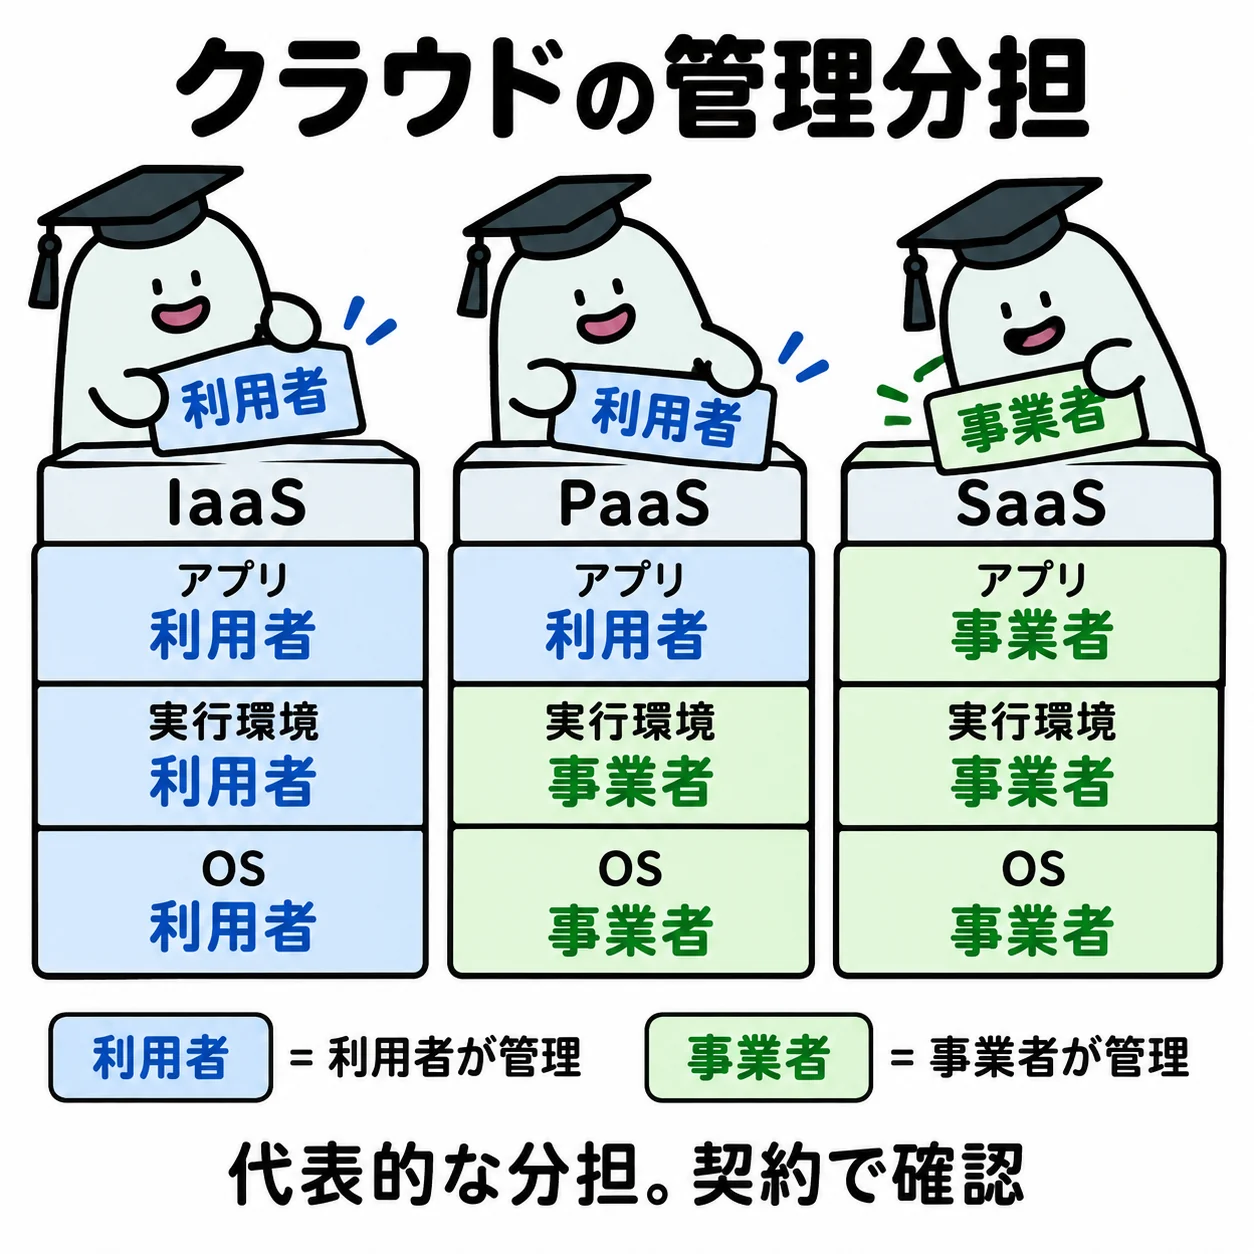
サーバを自社で所有しなくても、ネットワーク経由で計算資源やアプリを利用できます。どこまで提供者が管理し、利用者が何を管理するかを先に決めます。
基本の仕組み
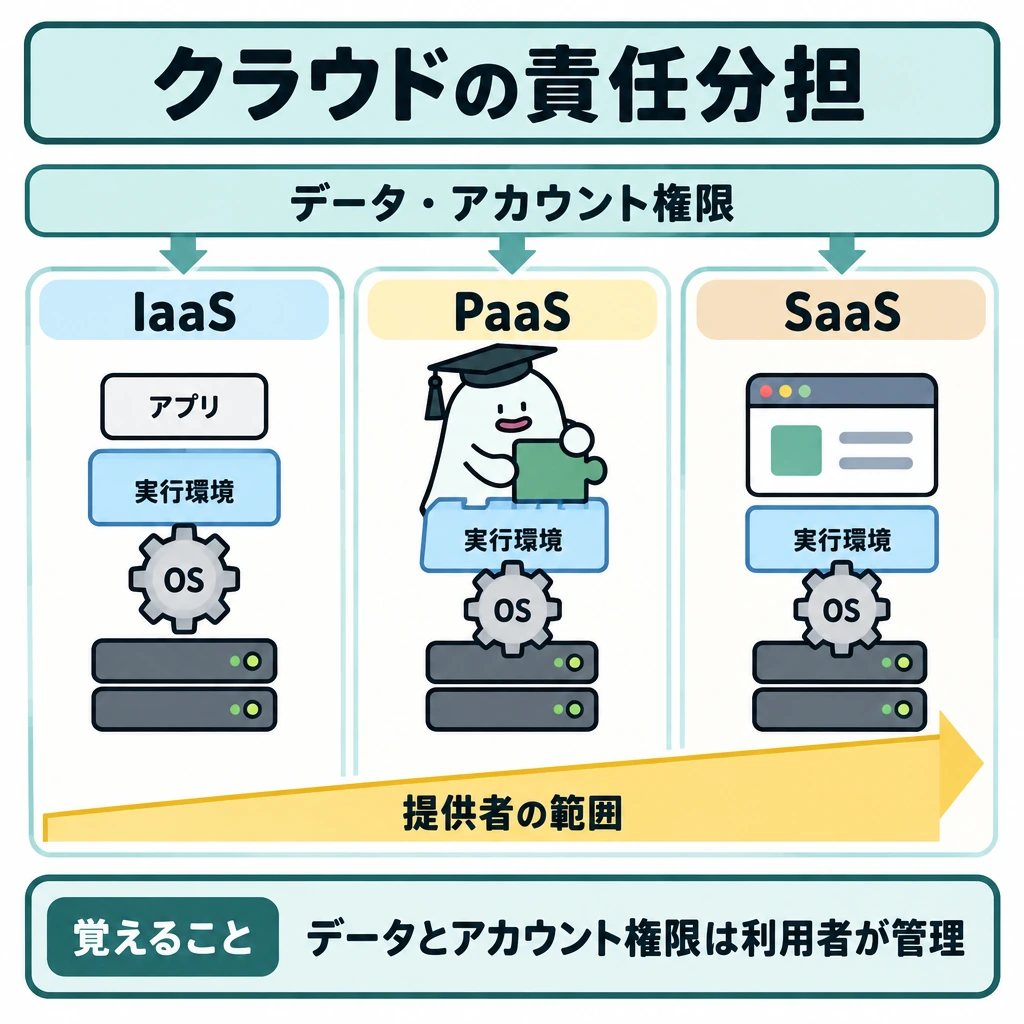
自分のプログラムを実行環境へ配置し、OSの更新は提供者に任せるならPaaSが候補です。仮想マシンを借りてOSから管理するIaaS、完成したアプリを利用するSaaSとは管理範囲が異なります。
仮想化ではハイパーバイザ等が物理資源を分け、複数の仮想マシンを動かします。コンテナは通常ホスト側のカーネルを共有して実行環境を分離します。どちらも物理装置一台とアプリ一個が常に対応するわけではありません。
クラウドでもアカウント権限や投入するデータの管理は残ります。可用性の保証範囲、バックアップ、障害時の復旧、利用量に応じた費用を確認します。SaaSなら情報漏えいの責任が全て利用者からなくなる、とはいえません。
どこまでを提供者が守り、どこからを利用者が守るかは、責任共有モデルとして整理されます。IaaS・PaaS・SaaSの順に提供者の範囲が広がりますが、利用者側にもデータやアカウント権限の管理が残ります。
クラウド利用者の責任
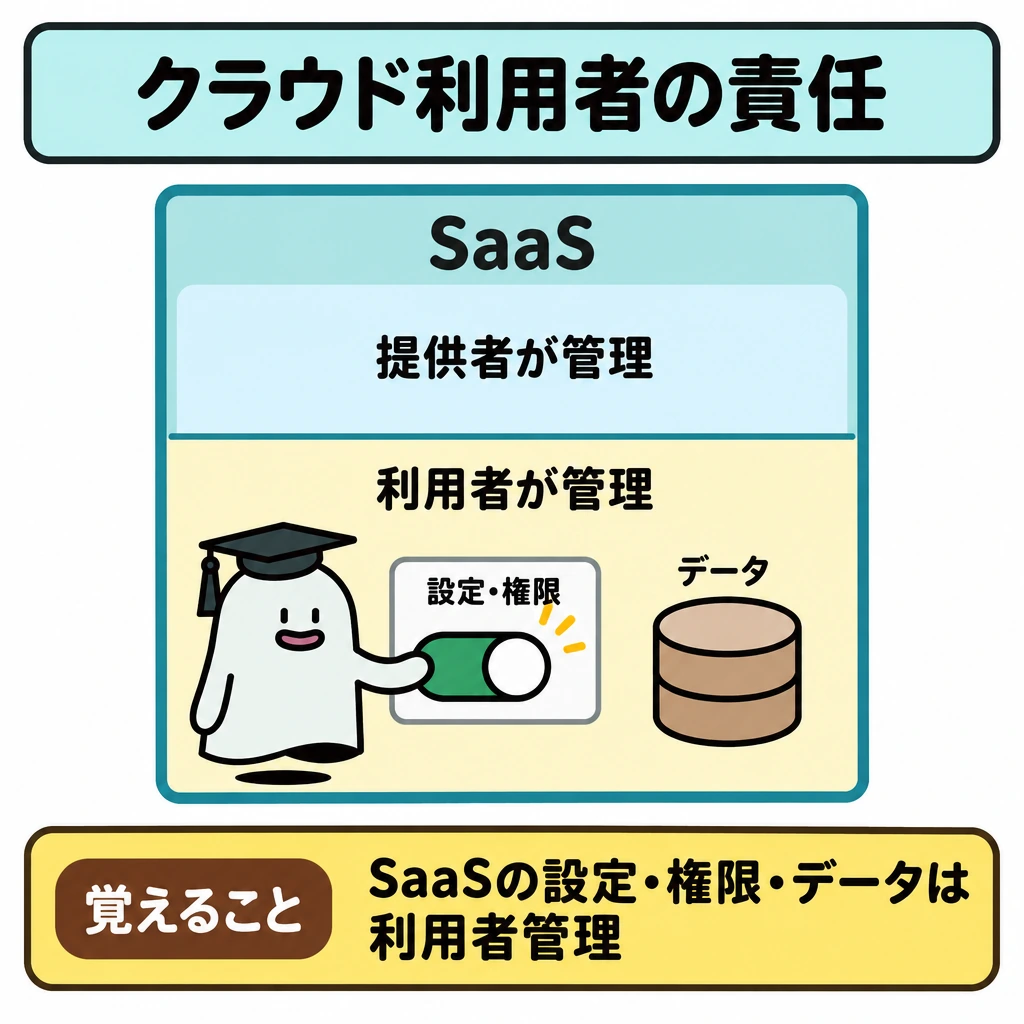
IaaS・PaaS・SaaSは提供者が管理する範囲が順に広がります。IaaSの利用者はOS設定やアプリ更新も担い、SaaSでも利用者のアカウント、権限、入力データの管理は残ります。仮想化は物理資源を論理的に分ける技術です。
| 方式 | 利用者が主に管理するもの |
|---|---|
| IaaS | OS・アプリ・データ |
| PaaS | アプリ・データ |
| SaaS | 設定・権限・データ |
試験に出る
- IaaS・PaaS・SaaSの管理範囲の違い(どこまで利用者が管理するか)。
- 仮想化はハイパーバイザ等が物理資源を分けること。
- コンテナは通常ホスト側のカーネルを共有する点。
- クラウドでもアカウント権限やデータ管理は利用者に残ること。
- 可用性の保証範囲やバックアップ、費用を契約で確認すること。
重要な言葉
- IaaS
- 仮想マシンなど基盤を提供し、OSから利用者が管理する形態。
- PaaS
- アプリを動かす環境を提供し、OS更新は提供者が担う形態。
- SaaS
- 完成したアプリをネット経由で利用する形態。
- ハイパーバイザ
- 物理資源を分けて複数の仮想マシンを動かすソフト。
- 責任共有モデル
- クラウドの提供者と利用者で、管理する範囲と責任を分ける考え方。
確認問題
確かめようOSを利用者が構築・更新する仮想マシン提供はPaaS?
通常IaaSです。サービス名ではなく契約で提供される管理範囲を読みます。
IaaSでは、利用者がOSから管理する。
クラウドを利用すれば、データ管理の責任は全て提供者に移る。
OSの更新を提供者に任せ、自分のプログラムを実行環境へ配置する形態は?
複数の仮想マシンを動かすため物理資源を分けるソフトは?
サーバを自社で所有しなくても、ネットワーク経由でやアプリを利用できます。どこまでが管理し、利用者が何を管理するかを先に決めます。
自分のプログラムを実行環境へ配置し、OSの更新は提供者に任せるならが候補です。仮想マシンを借りてOSから管理する、完成したアプリを利用するSaaSとは管理範囲が異なります。
仮想化では等が物理資源を分け、複数の仮想マシンを動かします。は通常ホスト側のカーネルを共有して実行環境を分離します。どちらも物理装置一台とアプリ一個が常に対応するわけではありません。
クラウドでもアカウント権限や投入するデータの管理は残ります。の保証範囲、バックアップ、障害時の復旧、利用量に応じた費用を確認します。SaaSならの責任が全て利用者からなくなる、とはいえません。
どこまでを提供者が守り、どこからを利用者が守るかは、として整理されます。IaaS・PaaS・SaaSの順に提供者の範囲が広がりますが、利用者側にもデータやアカウント権限の管理が残ります。
スラッシングと主記憶の不足
スラッシングとは、ページの入替えが頻発して処理効率が大きく落ちる現象です。
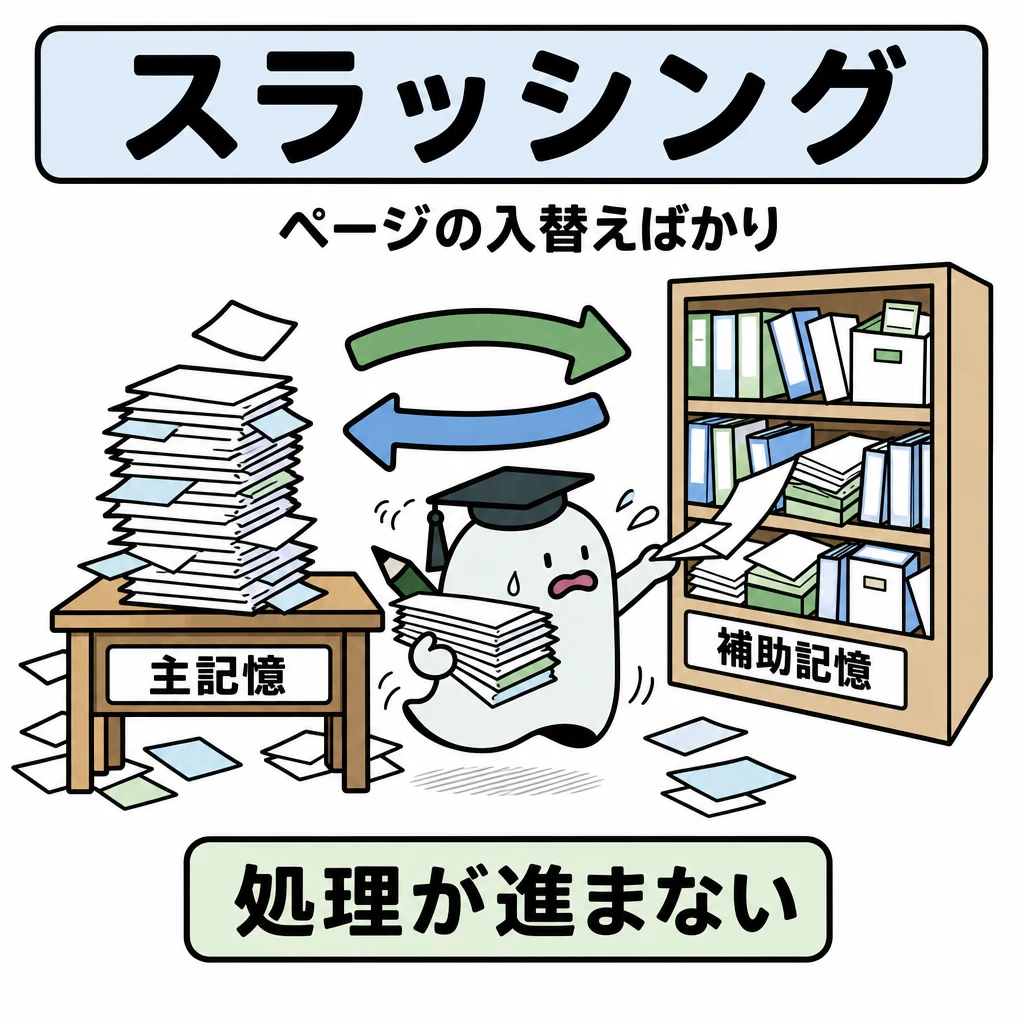
机に広げられる資料が少ないのに、同時に何件もの仕事を始めると、棚との出し入ればかりになってしまいます。仮想記憶でも、必要なページを主記憶へ置ききれないと似た状況が起きます。
基本の仕組み
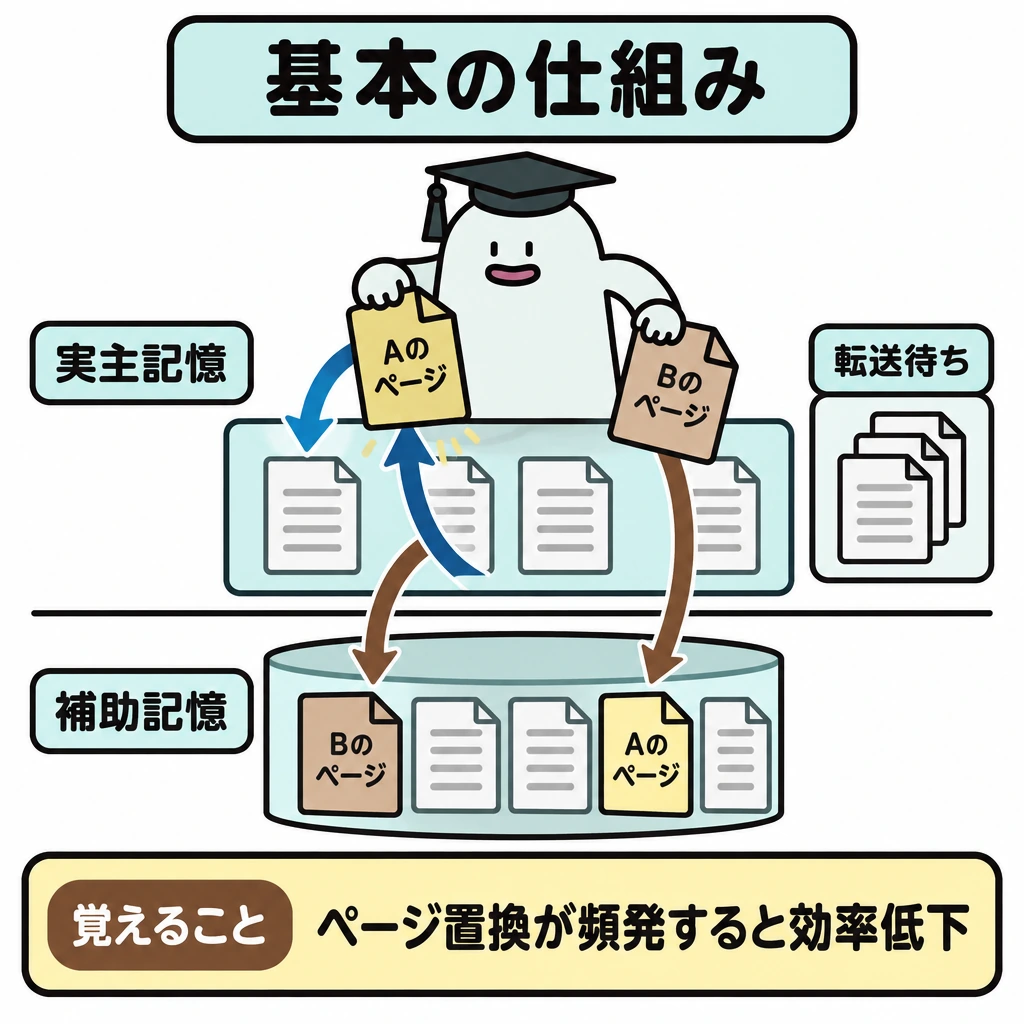
例えば、ある処理に必要なページを読み込むため別の処理のページを追い出し、次にその処理へ切り替えると追い出したページを再び読み込む、と繰り返す場合です。処理を増やしたのに計算が進まず、補助記憶との転送待ちが増えます。
このようにページの置換が頻発して処理効率が大きく落ちる現象をスラッシングと呼びます。問題文では、同時実行の多重度、実主記憶の不足、ページ入替えに費やす時間の関係を読み取ります。
対策は原因に合わせて、同時に実行する処理を減らす、必要な主記憶を確保するなどです。仮想アドレス空間や補助記憶を増やすだけで、実主記憶の不足による転送待ちがなくなるとは限りません。互いに資源を待って進めないデッドロックとは別の現象です。
ページングとスラッシング
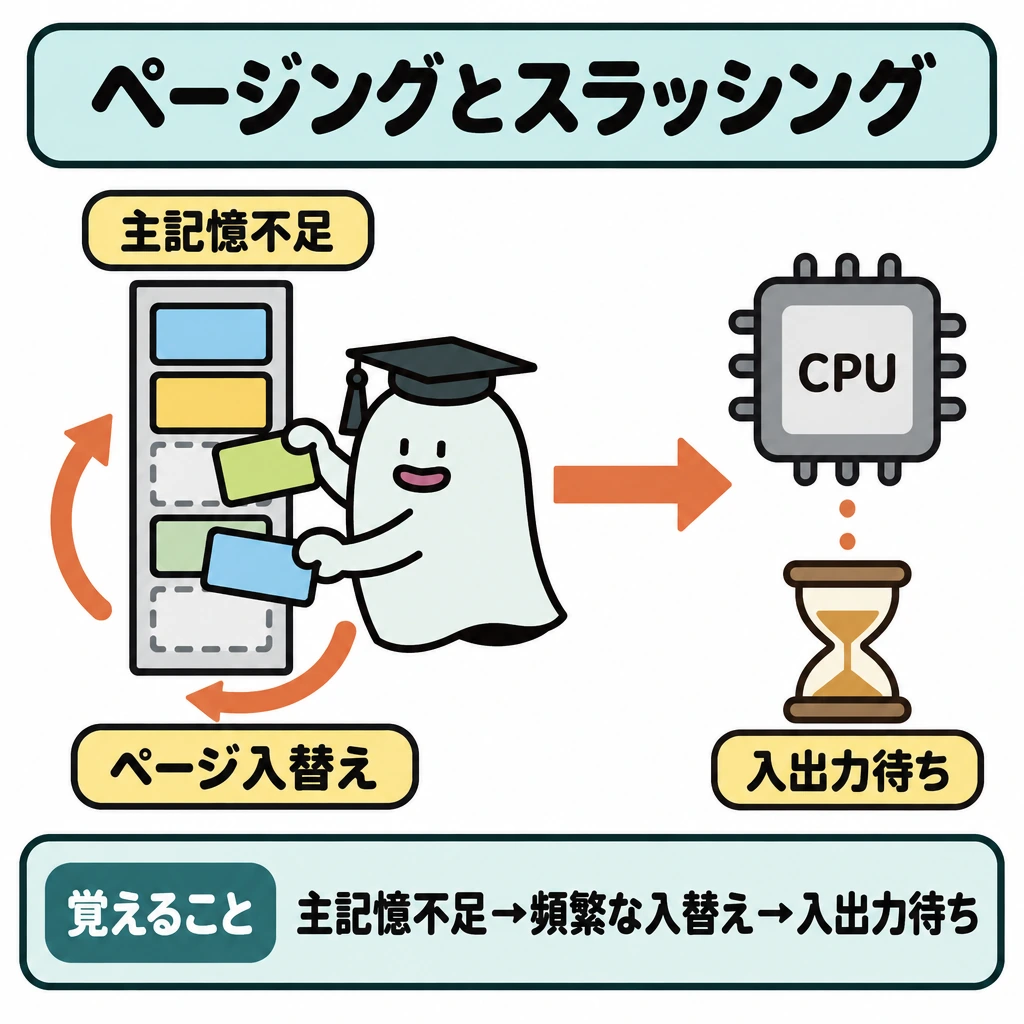
主記憶が不足しページの入替えが頻発すると、CPUが処理より入出力待ちに時間を費やすスラッシングが起こります。ページフォールト自体は仮想記憶の通常動作ですが、頻度が過大なら同時実行数やメモリ割当てを見直します。
| 状態 | 意味 |
|---|---|
| ページフォールト | 必要ページが主記憶にない |
| スラッシング | ページ入替えが過多 |
| 対策 | 実メモリ増設・同時実行の調整 |
試験に出る
- スラッシングはページ入替えの頻発で処理効率が落ちる現象。
- 同時実行の多重度・実主記憶の不足・入替え時間の関係を読み取ること。
- 対策は同時実行数の削減や必要な主記憶の確保。
- 補助記憶を増やすだけでは実主記憶の不足は解消しないこと。
- デッドロックとは別の現象であること。
重要な言葉
- スラッシング
- ページ入替えが頻発して処理効率が大きく落ちる現象。
- 多重度
- 同時に実行する処理の数。
- 仮想記憶
- 主記憶と補助記憶を組み合わせて管理する仕組み。
- デッドロック
- 互いに資源を待って進めなくなる状態。スラッシングとは別。
確認問題
確かめよう同時実行数を増やすほど処理効率は必ず上がる?
いいえ。必要なページを保持できなくなると、入替えが増えて逆に遅くなる場合があります。
同時実行数を増やせば、処理効率は必ず上がる。
スラッシングでは、CPUの計算よりページ入替えに時間が取られる。
ページ入替えが頻発して処理効率が大きく落ちる現象は?
スラッシングへの対策として適切なのは?
机に広げられる資料が少ないのに、同時に何件もの仕事を始めると、棚との出し入ればかりになってしまいます。でも、必要なページをへ置ききれないと似た状況が起きます。
例えば、ある処理に必要なページを読み込むため別の処理のページを追い出し、次にその処理へ切り替えると追い出したページを再び読み込む、と繰り返す場合です。処理を増やしたのに計算が進まず、とのが増えます。
このようにページの置換が頻発して処理効率が大きく落ちる現象をと呼びます。問題文では、同時実行の、実主記憶の不足、ページ入替えに費やす時間の関係を読み取ります。
対策は原因に合わせて、同時に実行する処理を減らす、必要な主記憶を確保するなどです。仮想アドレス空間や補助記憶を増やすだけで、の不足による転送待ちがなくなるとは限りません。互いに資源を待って進めないとは別の現象です。
覚えるポイント
- ハードウェア:キャッシュはよく使うデータを高速な記憶装置へ置きます。命令実行は取得・解読・実行などの段階に分けられ、パイプラインは複数命令の段階を重ねます。
- オペレーティングシステム:プロセスは実行中のプログラムの単位です。仮想記憶は主記憶と補助記憶を利用してアドレス空間を管理し、必要なページを主記憶へ読み込みます。
- システム構成:負荷分散は要求を複数の処理装置へ割り振り、冗長化は故障しても機能を維持する設計です。両方を行う構成もありますが、目的を分けて理解します。
- 性能評価:CPU時間は命令数×平均CPI÷クロック周波数で表せます。同じ命令数でも、命令当たりのクロック数や周波数で所要時間が変わります。
- 信頼性と稼働率:稼働率はMTBF÷(MTBF+MTTR)で考えます。独立した装置を両方必要とする直列系では稼働率を掛け、どちらか一つでよい並列系では両方停止する確率を1から引きます。
- クラウド・仮想化と責任分担:仮想化ではハイパーバイザ等が物理資源を分け、複数の仮想マシンを動かします。コンテナは通常ホスト側のカーネルを共有して実行環境を分離します。どちらも物理装置一台とアプリ一個が常に対応するわけではありません。
- スラッシングと主記憶の不足:スラッシングとは、ページの入替えが頻発して処理効率が大きく落ちる現象です。
出典・参考資料
試験の公式案内と、この記事の参考にした学習資料です。
編集:Pinternet Works · 更新日:
教材の編集方針・訂正について